Desmontando executáveis Bun com unbuned
Traduzido do inglês. Leia o original em English.
Por que eu construí isso
Eu gosto de fazer engenharia reversa e ver como os apps realmente funcionam por baixo dos panos. Muitas das ferramentas que eu uso começaram a ser distribuídas como apps Bun compilados. Agentes de código, CLIs e apps desktop agora vêm todos como um exe gigante e você não consegue simplesmente abrir uma pasta e ler o JavaScript como fazia com um app Node normal.
Então eu construí o unbuned. Você entrega o exe e ele devolve o código dividido nos arquivos reais, com os nomes reais. Se o app foi compilado com source maps, você ainda recebe o TypeScript original de volta. É um único arquivo Python, sem dependências.
Este post mostra o que realmente existe dentro de um executável Bun e como o unbuned o desmonta. Todo número aqui vem de um binário real e de um único comando, então você pode conferir tudo por conta própria.
O que é um executável Bun
Quando você roda bun build --compile, o Bun pega o próprio runtime e cola o seu app já empacotado em cima dele. O runtime é o mesmo para todo app. O seu código fica em uma seção própria do binário:
| Plataforma | Onde o app fica |
|---|---|
| Windows PE | uma seção chamada .bun |
| Linux ELF | uma seção chamada .bun |
| macOS Mach-O | o segmento e seção __BUN,__bun, em binários thin ou universais |
Essa seção é o alvo inteiro. Todo o resto do arquivo é o Bun em si e não interessa aqui. A primeira tarefa é encontrar a seção.
Passo 1: Encontrando a seção
No Windows isso significa percorrer a tabela de seções do PE. A tabela começa logo depois do optional header e cada entrada tem 40 bytes, com o nome nos primeiros 8:
num_sections = struct.unpack('<H', data[pe_offset+6:pe_offset+8])[0]
optional_header_size = struct.unpack('<H', data[pe_offset+20:pe_offset+22])[0]
section_table_offset = pe_offset + 24 + optional_header_size

for i in range(num_sections):
    section_offset = section_table_offset + (i * 40)
    section_name = data[section_offset:section_offset+8].rstrip(b'\x00').decode('ascii', errors='ignore')
    if section_name == '.bun':
        ...
ELF e Mach-O recebem o mesmo tratamento, com seus próprios headers. Em um Mach-O universal, ele escolhe primeiro a fatia da arquitetura certa. Se nada disso funcionar, ele recorre a uma busca pelos magic bytes do Bun, para que um binário com metadados de seção quebrados ainda possa ser lido.
O arquivo é mapeado em memória em vez de carregado na RAM. Alguns desses binários têm quase 300 MB e não há motivo para ler tudo isso.
Passo 2: O Bun deixa um mapa no final
Essa é a parte que tornou possível recuperar os nomes reais dos arquivos. O Bun não se limita a concatenar o seu código. Antes de escrever a seção, ele monta uma tabela de todos os arquivos embutidos, chamada StandaloneModuleGraph, e coloca essa tabela bem no final.
Os últimos 16 bytes da seção são um marcador literal:
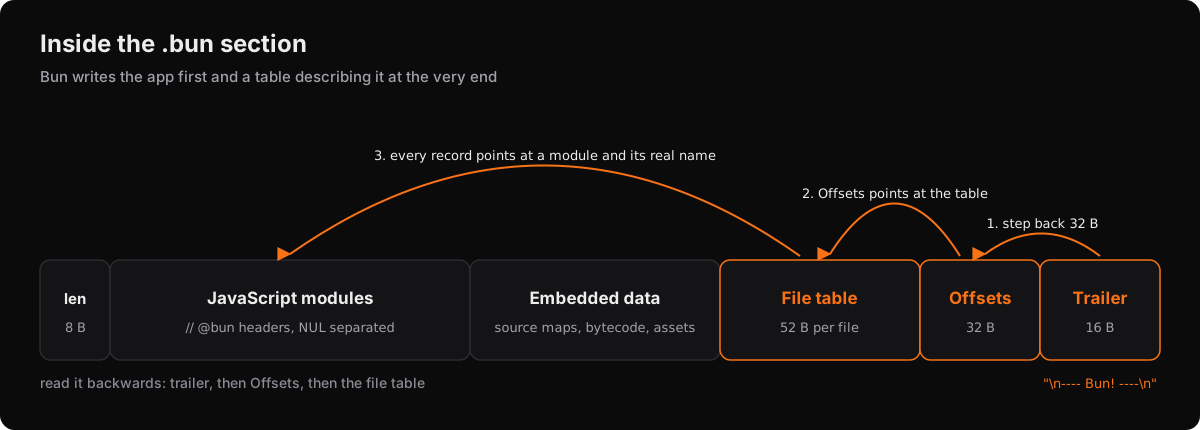
\n---- Bun! ----\nOs 32 bytes imediatamente antes desse marcador são uma struct Offsets. Ela guarda o tamanho dos dados, um ponteiro para a tabela de arquivos, o id do ponto de entrada e um conjunto de flags:
...file records...
Offsets   { byte_count, modules_ptr, entry_point_id, compile_exec_argv_ptr, flags }
TRAILER   "\n---- Bun! ----\n"
Então você procura o trailer a partir do final, volta 32 bytes e já sabe onde está a tabela de arquivos. Cada arquivo ganha um registro de 52 bytes:
name                  { u32 offset, u32 length }
contents              { u32 offset, u32 length }
sourcemap             { u32 offset, u32 length }
bytecode              { u32 offset, u32 length }
module_info           { u32 offset, u32 length }
bytecode_origin_path  { u32 offset, u32 length }
encoding              u8     0 binary, 1 latin1, 2 utf16
loader                u8     0 js, 1 jsx, 2 ts, 3 tsx, 4 json, 5 file, ...
module_format         u8     0 none, 1 esm, 2 cjs
side                  u8     0 server, 1 client
Um detalhe importa mais do que parece. Todos esses offsets são relativos ao início da seção mais o header de tamanho da própria seção, que tem 8 bytes. Se você esquecer esse +8, todo ponteiro cai 8 bytes antes e a tabela inteira vira lixo. O parser também confere isso. Se byte_count + 8 não cair exatamente no header, ele recusa a tabela em vez de lê-la pela metade.
Os registros são escritos na ordem de carregamento, com o ponto de entrada primeiro. Isso significa que o offset de contents de um módulo é exatamente onde o texto dele começa no bundle, e dar nome a um módulo vira uma consulta em vez de um palpite. O CLI Droid da Factory é um binário de 275 MB, e rodar o unbuned nele dá:
modules named from module graph: 623 of 623
Module graph: 706 embedded files
Entry point: B:/~BUN/root/droid
Graph loaders: 623 jsx, 43 binary, 40 file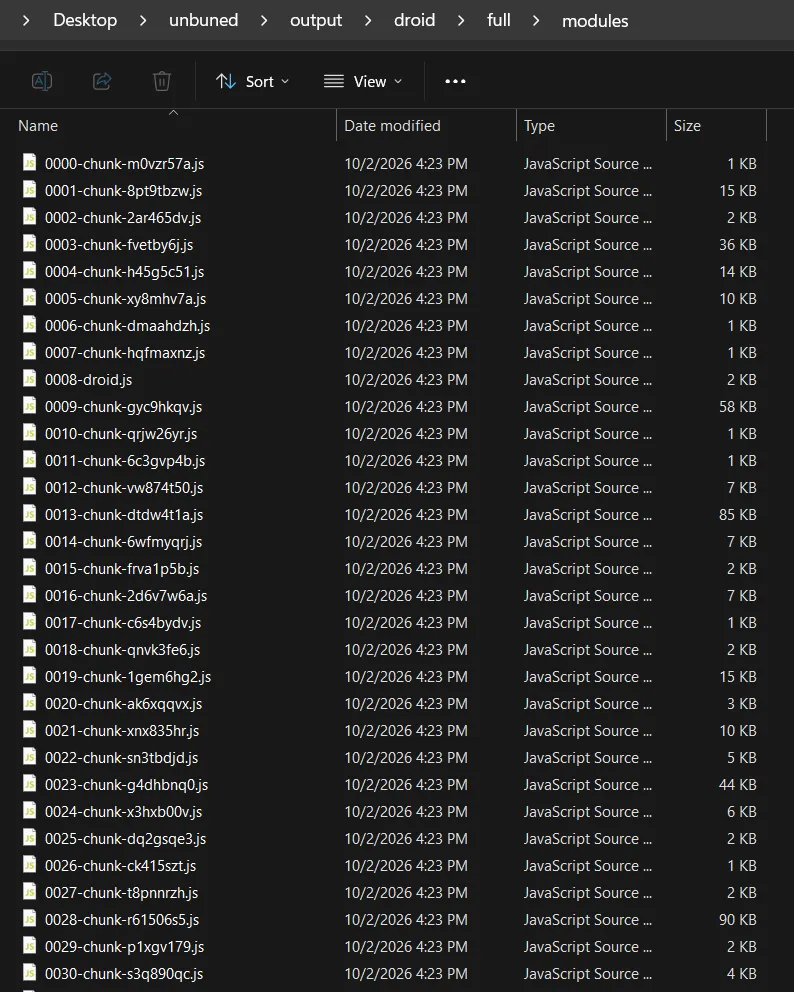
O grafo não consegue devolver nomes que o Bun já jogou fora. Quando ele escreve a tabela, os chunks já estão com hash em coisas como chunk-9fxe9jf7.js, então é isso que você recebe. O unbuned relata o que o compilador registrou e não finge saber mais do que isso.
Passo 3: Onde o JavaScript termina
O bundle em si é uma lista de módulos compilados. Cada um começa com uma linha de header // @bun e eles são separados por um byte NUL. Achar onde ele começa é fácil. Achar onde termina foi a parte difícil.
Logo depois do último módulo vêm os metadados do Bun, e eles não são puramente binários. O Bun mistura bytes imprimíveis nessa região, então a área depois do código fica com cerca de 60% de bytes não textuais, enquanto código-fonte normal fica abaixo de 10%. Alguns módulos também contêm bytes NUL de verdade, então você não pode simplesmente parar no primeiro.
O que funcionou foi varrer para frente a partir do último header de módulo sabidamente textual e parar onde a densidade de bytes não textuais dispara. Ele faz uma passada grossa e depois uma passada fina, e assim cai no byte exato em vez de na borda de uma janela de varredura. Ele também procura os marcadores que o Bun deixa no fim do código, como //# sourceMappingURL= e //# debugId=.
A verificação de bytes roda via bytes.translate, então uma seção de 150 MB é varrida dentro do código C do CPython em vez de em um loop Python.
Acertar isso com exatidão foi importante. Uma versão anterior parava na borda de uma janela e, no CLI do Amp, cortava o export default b3n(); final no meio. Agora esse bundle termina onde o código-fonte termina e passa no node --check.
A surpresa do UTF-16
O CLI do Amp também me ensinou que nem todo bundle Bun é feito de bytes simples. A região inteira de JavaScript dele é UTF-16, então todo caractere ASCII é seguido por um NUL de preenchimento. Uma busca de bytes por // @bun não encontra nada e toda razão de texto aparece como metade binário.
Então o unbuned agora procura o marcador primeiro como bytes simples e depois como UTF-16 nas duas ordens de bytes, e carrega a codificação encontrada por todos os passos seguintes. Os offsets continuam nas posições originais dos bytes, então o manifesto ainda descreve o arquivo como ele está no disco. O texto só é convertido para UTF-8 na hora de gravar.
Passo 4: Recuperando o TypeScript original
Se o app foi compilado com source maps, o Bun guarda o texto original de cada arquivo dentro do registro de source map para o qual cada módulo aponta. Esse é o único lugar onde o TypeScript original sobrevive, porque o bundle em si já está achatado em chunks.
Não é o source map em JSON que você esperaria. O Bun lê esse JSON uma vez durante a compilação e grava uma tabela compacta no lugar:
| Offset | Conteúdo |
|---|---|
0 | u32 quantidade de sources |
4 | u32 tamanho do mapeamento VLQ bruto |
8 | um ponteiro {offset, length} por caminho de source |
| depois | um ponteiro {offset, length} por texto de source |
| depois | o blob de mapeamento VLQ |
| depois | cada caminho, e então cada texto de source comprimido com Zstandard |
Os caminhos são relativos ao arquivo que os importou, então uma dependência compartilhada aparece como ../../node_modules/.... Remover as partes .. do início coloca cada arquivo de volta onde ele realmente estava:
src/index.ts
src/exec/acpDaemonRunner.ts
packages/logging/src/tracing/enums.ts
node_modules/@opentelemetry/api/build/src/version.js
No Droid são 4.914 arquivos originais e 42,6 MB de código-fonte: 2.487 arquivos de dependências, 1.281 arquivos do próprio src do app e 1.146 arquivos dos pacotes do workspace.
O Freebuff mostra por que isso importa. Ele entrega um único módulo minificado com 7,4 MB de nomes como zUA e xH, sem nada para dividir. O source map dele ainda continha o projeto real, e o unbuned extraiu 1.241 arquivos originais e 13,5 MB de TypeScript e JavaScript organizados nas pastas reais src/, common/, packages/ e sdk/.
As outras coisas lá dentro
Bytecode
Se um app é compilado com --bytecode, o JavaScript que você extrai é só o fallback. O que realmente roda é bytecode do JavaScriptCore. O unbuned avisa quando esse é o caso e pode gravar um blob de bytecode por módulo usando os ponteiros do grafo de módulos. Todo blob começa com o mesmo header, e o tamanho nesse header bateu com o tamanho do grafo em todos os módulos que testei, o que é uma boa confirmação de que a extração está certa.
Ele não converte bytecode de volta em JavaScript. O bytecode do JSC não é documentado e muda entre versões, então isso seria um backend de compilador inteiro e não uma funcionalidade de fim de semana.
Arquivos embutidos
Um app Bun não é só JavaScript. Outros arquivos ficam guardados na mesma seção e muitos deles estão comprimidos como frames Zstandard. O Droid carrega 80 deles, somando cerca de 88 MB, incluindo rg.exe, keytar, as bibliotecas rust_pty para quatro plataformas e os arquivos SKILL.md que o agente dele lê. O grafo de módulos nomeia os 80, então eles voltam com seus nomes reais. O Zstandard é a única peça opcional. Sem ele os arquivos ainda são extraídos, só que continuam comprimidos.
Deixando legível
O Bun entrega código minificado, e código minificado é uma linha gigante por módulo. O Prettier e os outros formatadores são pacotes Node que montam uma árvore sintática completa, e isso não combina com uma ferramenta Python de um arquivo só e fica lento em um bundle de 40 MB.
Então o unbuned tem o próprio formatador. É um lexer de passada única que só olha para as coisas que mudam o layout, como strings, template literals, comentários, literais de regex, operadores e colchetes, e copia tudo o que está no meio do jeito que está.
Ele tem uma regra inflexível. Ele só adiciona ou remove espaço em branco. Nenhum token é reescrito e nada é reordenado, então isto sempre vale:
assert "".join(extracted.split()) == "".join(formatted.split())Testar o formatador revelou uma armadilha no Node também. O node --check module.js só faz o parse de verdade quando o arquivo não tem import nem export. Um bundle Bun sempre tem, então checar pelo caminho do arquivo passa sem fazer parse de nada. Você precisa passar pelo pipe:
node --check --input-type=module < module.jsProvando que funciona
O teste de verdade foi o CLI do Cline na versão 3.0.68. Ele tem 212 módulos separados e quebrou o extrator mais do que qualquer outro alvo. Um módulo estava escondido atrás de um shebang que nenhum padrão de header conseguia enxergar, e o formatador estava adicionando espaços silenciosamente dentro de URLs em um arquivo de query do tree-sitter embutido. Os dois problemas foram corrigidos por causa desse único binário.
Depois dessas correções, os módulos remontados batem com o bundle original byte a byte:
modules: 212
js length: 18386663
rebuilt length: 18386663
identical: True
Então eu gravei a árvore de módulos de volta no disco com os 13 assets ao lado e executei. O CLI extraído responde --version com o mesmo 3.0.68 do binário real. Testei 19 comandos somente leitura, como --version, --help e --help em cada subcomando, e todos deram saída idêntica byte a byte e o mesmo código de saída do original. Isso é uma verificação muito melhor do que a saída simplesmente parecer JavaScript.
Experimente
git clone https://github.com/vibheksoni/unbuned.git
cd unbuned
python unbuned.py app.exe            # the merged JavaScript
python unbuned.py app.exe --inspect  # what is inside, without writing anything
python unbuned.py app.exe --all      # modules, original sources, assets and bytecode
O --all no Droid grava mais de 6.000 arquivos em cerca de quatro segundos e meio.
Se você quiser ver funcionando com algo que você conhece, é só compilar um app pequeno com bun build --compile --sourcemap e rodar o unbuned nele. Você deve receber de volta os seus próprios arquivos com os nomes reais.
Use em binários que você tem permissão de analisar. Ele foi feito para engenharia reversa, pesquisa de segurança, análise de malware e para recuperar o seu próprio código quando o projeto sumiu mas o exe ainda existe.
O código está no GitHub. Se algo quebrar em um binário Bun que você tenha, abra uma issue, porque a maioria das correções nesta ferramenta veio de um binário real quebrando ela.