Démonter les exécutables Bun avec unbuned
Traduit de l’anglais. Lire l’original en English.
Pourquoi je l’ai construit
J’aime faire du reverse et voir comment les applications fonctionnent vraiment sous le capot. Beaucoup des outils que j’utilise ont commencé à être livrés sous forme d’applications Bun compilées. Les agents de code, les CLI et les applications de bureau arrivent maintenant tous dans un gros exe, et on ne peut plus simplement ouvrir un dossier et lire le JavaScript comme on le ferait avec une application Node classique.
J’ai donc construit unbuned. Vous lui donnez l’exe et il vous rend le code découpé en vrais fichiers avec leurs vrais noms. Si l’application a été construite avec des source maps, vous récupérez même le TypeScript d’origine. C’est un seul fichier Python, sans aucune dépendance.
Cet article explique ce qu’il y a vraiment dans un exécutable Bun et comment unbuned le démonte. Chaque nombre cité ici vient d’un vrai binaire et d’une seule commande, donc vous pouvez tout vérifier vous-même.
Ce qu’est un exécutable Bun
Quand vous lancez bun build --compile, Bun prend son propre runtime et colle votre application bundlée dessus. Le runtime est identique pour toutes les applications. Votre code vit dans sa propre section du binaire :
| Plateforme | Où vit l’application |
|---|---|
| Windows PE | une section nommée .bun |
| Linux ELF | une section nommée .bun |
| macOS Mach-O | le segment et la section __BUN,__bun, dans les binaires thin ou universal |
Cette section est toute la cible. Le reste du fichier, c’est Bun lui-même, et ça n’a aucun intérêt ici. Le premier travail consiste à trouver la section.
Étape 1 : trouver la section
Sous Windows, cela veut dire parcourir la table des sections du PE. La table commence juste après l’optional header et chaque entrée fait 40 octets, avec le nom dans les 8 premiers :
num_sections = struct.unpack('<H', data[pe_offset+6:pe_offset+8])[0]
optional_header_size = struct.unpack('<H', data[pe_offset+20:pe_offset+22])[0]
section_table_offset = pe_offset + 24 + optional_header_size

for i in range(num_sections):
    section_offset = section_table_offset + (i * 40)
    section_name = data[section_offset:section_offset+8].rstrip(b'\x00').decode('ascii', errors='ignore')
    if section_name == '.bun':
        ...
ELF et Mach-O reçoivent le même traitement avec leurs propres en-têtes. Pour un Mach-O universal, il choisit d’abord la bonne tranche d’architecture. Si rien de tout cela ne marche, il se rabat sur une recherche des octets magiques de Bun, pour qu’un binaire dont les métadonnées de section sont cassées puisse quand même être lu.
Le fichier est mappé en mémoire au lieu d’être chargé en RAM. Certains de ces binaires font près de 300 Mo et il n’y a aucune raison de tout lire.
Étape 2 : Bun laisse une carte à la fin
C’est la partie qui a rendu possibles les vrais noms de fichiers. Bun ne se contente pas de concaténer votre code. Avant d’écrire la section, il construit une table de tous les fichiers qu’il a embarqués, appelée le StandaloneModuleGraph, et il la place tout à la fin.
Les 16 derniers octets de la section sont un marqueur littéral :
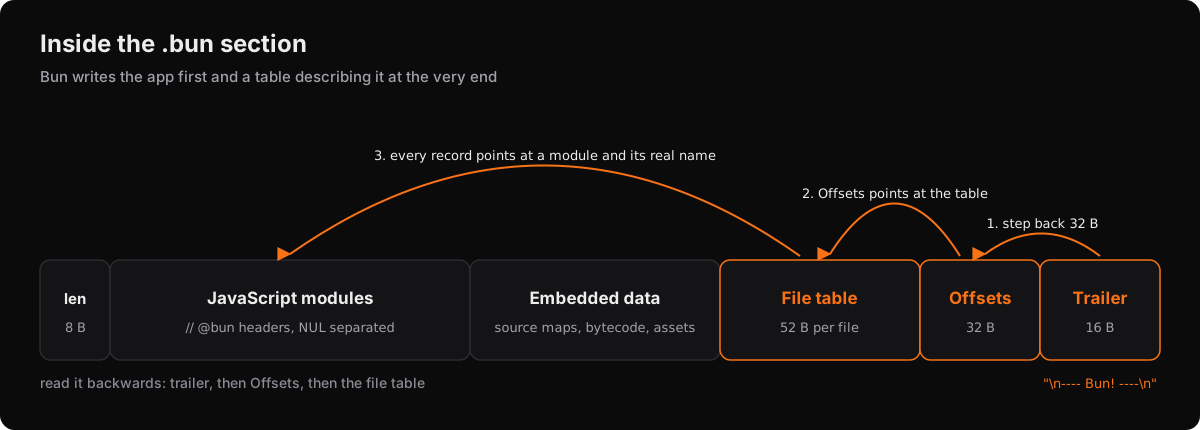
\n---- Bun! ----\nLes 32 octets juste avant ce marqueur forment une structure Offsets. Elle contient la taille des données, un pointeur vers la table des fichiers, l’id du point d’entrée et un ensemble de flags :
...file records...
Offsets   { byte_count, modules_ptr, entry_point_id, compile_exec_argv_ptr, flags }
TRAILER   "\n---- Bun! ----\n"
On cherche donc le trailer depuis la fin, on recule de 32 octets et on sait où se trouve la table des fichiers. Chaque fichier a un enregistrement de 52 octets :
name                  { u32 offset, u32 length }
contents              { u32 offset, u32 length }
sourcemap             { u32 offset, u32 length }
bytecode              { u32 offset, u32 length }
module_info           { u32 offset, u32 length }
bytecode_origin_path  { u32 offset, u32 length }
encoding              u8     0 binary, 1 latin1, 2 utf16
loader                u8     0 js, 1 jsx, 2 ts, 3 tsx, 4 json, 5 file, ...
module_format         u8     0 none, 1 esm, 2 cjs
side                  u8     0 server, 1 client
Un détail compte plus qu’il n’y paraît. Chacun de ces offsets est relatif au début de la section plus l’en-tête de longueur de 8 octets de la section elle-même. Si vous oubliez ce +8, chaque pointeur tombe 8 octets trop tôt et toute la table se lit comme du charabia. Le parseur vérifie aussi ce point. Si byte_count + 8 ne tombe pas exactement sur l’en-tête, il refuse la table au lieu de la lire à moitié.
Les enregistrements sont écrits dans l’ordre de chargement, avec le point d’entrée en premier. Cela veut dire que l’offset contents d’un module est exactement l’endroit où son texte commence dans le bundle, et nommer un module devient une simple recherche au lieu d’une devinette. Le CLI Droid de Factory est un binaire de 275 Mo et lancer unbuned dessus donne :
modules named from module graph: 623 of 623
Module graph: 706 embedded files
Entry point: B:/~BUN/root/droid
Graph loaders: 623 jsx, 43 binary, 40 file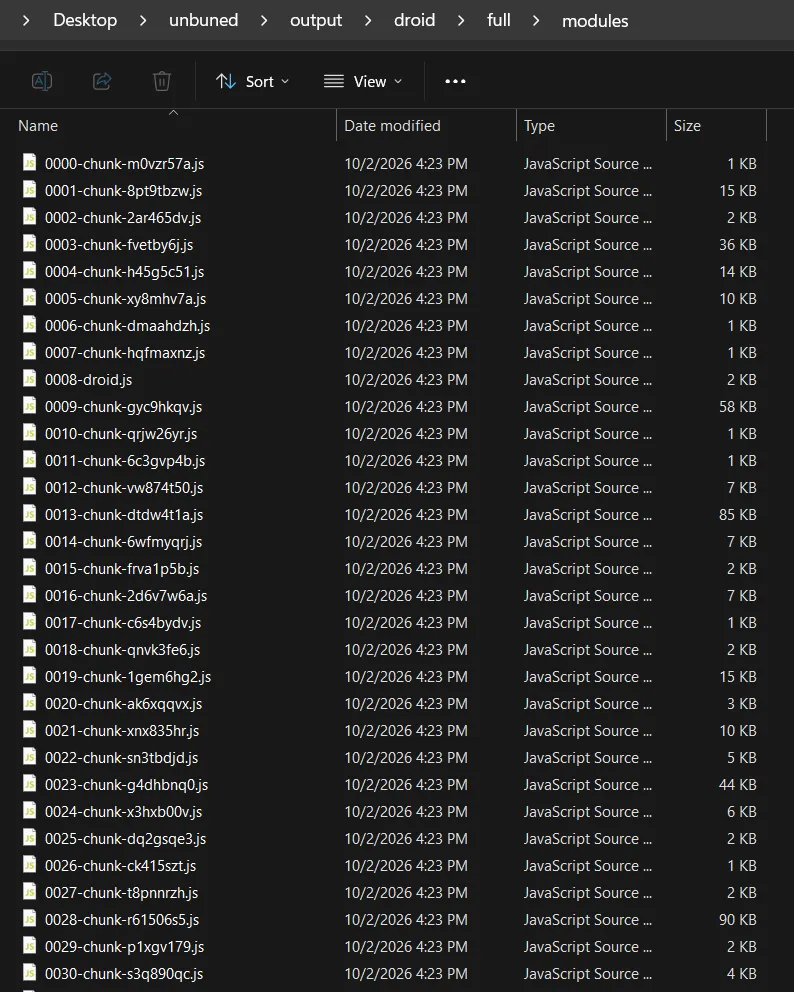
Le graphe ne peut pas vous donner les noms que Bun a déjà jetés. Au moment où il écrit la table, les chunks sont déjà hashés en quelque chose comme chunk-9fxe9jf7.js, et c’est donc ce que vous obtenez. unbuned rapporte ce que le compilateur a enregistré et ne prétend pas en savoir plus.
Étape 3 : où le JavaScript se termine
Le bundle lui-même est une liste de modules compilés. Chacun commence par une ligne d’en-tête // @bun et ils sont séparés par un octet NUL. Trouver où ça commence est facile. Trouver où ça se termine a été la partie difficile.
Juste après le dernier module viennent les métadonnées de Bun, et elles ne sont pas proprement binaires. Bun y mélange des octets imprimables, si bien que la région après le code tourne autour de 60 % de non-texte alors qu’un source normal reste sous les 10 %. Certains modules contiennent aussi de vrais octets NUL, donc on ne peut pas simplement s’arrêter au premier.
Ce qui a marché, c’est de scanner vers l’avant à partir du dernier en-tête de module connu pour être du texte, et de s’arrêter là où la densité d’octets non texte fait un bond. Il fait une passe grossière puis une passe fine, et tombe sur l’octet exact au lieu du bord d’une fenêtre de scan. Il cherche aussi les marqueurs que Bun laisse à la fin du code, comme //# sourceMappingURL= et //# debugId=.
La vérification des octets passe par bytes.translate, ce qui fait qu’une section de 150 Mo est scannée dans le code C de CPython au lieu d’une boucle Python.
Il était important d’être exact. Une version précédente s’arrêtait sur le bord d’une fenêtre et, sur le CLI d’Amp, elle coupait en deux le export default b3n(); final. Maintenant ce bundle se termine là où le source se termine et il passe node --check.
La surprise de l’UTF-16
Le CLI d’Amp m’a aussi appris que tous les bundles Bun ne sont pas en octets simples. Toute sa région JavaScript est en UTF-16, donc chaque caractère ASCII est suivi d’un NUL de remplissage. Une recherche d’octets pour // @bun ne trouve rien et tous les ratios de texte se lisent comme à moitié binaires.
unbuned cherche donc maintenant le marqueur d’abord en octets simples, puis en UTF-16 dans les deux ordres d’octets, et transporte l’encodage trouvé à travers toutes les étapes suivantes. Les offsets restent dans les positions d’octets d’origine, si bien que le manifest décrit toujours le fichier tel qu’il est sur le disque. Le texte n’est converti en UTF-8 qu’au moment de l’écriture.
Étape 4 : récupérer le TypeScript d’origine
Si l’application a été construite avec des source maps, Bun garde le texte d’origine de chaque fichier dans l’enregistrement de source map vers lequel pointe chaque module. C’est le seul endroit où le TypeScript d’origine survit, parce que le bundle lui-même est déjà aplati en chunks.
Ce n’est pas la source map JSON à laquelle on s’attend. Bun lit ce JSON une fois pendant la compilation et écrit à la place une table compacte :
| Offset | Contenu |
|---|---|
0 | u32 nombre de sources |
4 | u32 longueur du mapping VLQ brut |
8 | un pointeur {offset, length} par chemin de source |
| ensuite | un pointeur {offset, length} par texte de source |
| ensuite | le blob de mapping VLQ |
| ensuite | tous les chemins, puis chaque texte de source compressé avec Zstandard |
Les chemins sont relatifs au fichier qui les a importés, donc une dépendance partagée apparaît sous la forme ../../node_modules/.... Supprimer les parties .. du début remet chaque fichier là où il était vraiment :
src/index.ts
src/exec/acpDaemonRunner.ts
packages/logging/src/tracing/enums.ts
node_modules/@opentelemetry/api/build/src/version.js
Sur Droid, cela représente 4 914 fichiers d’origine et 42,6 Mo de source : 2 487 fichiers de dépendances, 1 281 fichiers du src propre à l’application et 1 146 fichiers de ses packages de workspace.
Freebuff montre pourquoi c’est important. Il livre un unique module minifié avec 7,4 Mo de noms comme zUA et xH, sans rien à découper. Sa source map contenait pourtant le vrai projet et unbuned en a sorti 1 241 fichiers d’origine et 13,5 Mo de TypeScript et de JavaScript, rangés dans les vrais dossiers src/, common/, packages/ et sdk/.
Le reste du contenu
Bytecode
Si une application est construite avec --bytecode, le JavaScript que vous extrayez n’est que le plan B. Ce qui s’exécute vraiment, c’est du bytecode JavaScriptCore. unbuned vous prévient quand c’est le cas et peut écrire un blob de bytecode par module en utilisant les pointeurs du graphe de modules. Chaque blob commence par le même en-tête, et la longueur dans cet en-tête correspondait à la longueur du graphe pour chaque module que j’ai testé, ce qui est une bonne vérification que l’extraction est correcte.
Il ne retransforme pas le bytecode en JavaScript. Le bytecode JSC n’est pas documenté et change d’une version à l’autre, donc ce serait un backend de compilateur entier et pas une fonctionnalité d’un week-end.
Fichiers embarqués
Une application Bun n’est pas faite que de JavaScript. D’autres fichiers sont stockés dans la même section et beaucoup sont compressés sous forme de frames Zstandard. Droid en livre 80, pour environ 88 Mo au total, dont rg.exe, keytar, les bibliothèques rust_pty pour quatre plateformes et les fichiers SKILL.md que lit son agent. Le graphe de modules nomme les 80, donc ils reviennent avec leurs vrais noms. Zstandard est la seule pièce optionnelle. Sans lui, les fichiers sont quand même extraits, mais restent compressés.
Le rendre lisible
Bun livre du code minifié et le code minifié, c’est une seule ligne géante par module. Prettier et les autres formateurs sont des paquets Node qui construisent un arbre syntaxique complet, ce qui ne convient pas à un outil Python en un seul fichier et devient lent sur un bundle de 40 Mo.
unbuned a donc son propre formateur. C’est un lexer en une seule passe qui ne cherche que les éléments qui changent la mise en page, comme les chaînes, les template literals, les commentaires, les littéraux regex, les opérateurs et les crochets, et qui recopie tout ce qu’il y a entre les deux tel quel.
Il a une règle absolue. Il ne fait qu’ajouter ou retirer des espaces blancs. Aucun token n’est réécrit et rien n’est réordonné, donc ceci est toujours vrai :
assert "".join(extracted.split()) == "".join(formatted.split())Tester le formateur a aussi révélé un piège dans Node. node --check module.js ne parse vraiment un fichier que s’il ne contient ni import ni export. Un bundle Bun en contient toujours, donc vérifier par chemin de fichier passe sans rien parser. Il faut le passer par l’entrée standard :
node --check --input-type=module < module.jsProuver que ça marche
Le vrai test a été le CLI de Cline en version 3.0.68. Il a 212 modules séparés et il a cassé l’extracteur plus que n’importe quelle autre cible. Un module se cachait derrière un shebang qu’aucun motif d’en-tête ne pouvait voir, et le formateur ajoutait discrètement des espaces dans les URL à l’intérieur d’un fichier de requêtes tree-sitter embarqué. Les deux problèmes ont été corrigés grâce à ce seul binaire.
Après ces corrections, les modules remis ensemble correspondent au bundle d’origine octet pour octet :
modules: 212
js length: 18386663
rebuilt length: 18386663
identical: True
Ensuite, j’ai réécrit l’arborescence de modules sur le disque avec les 13 assets à côté et je l’ai exécutée. Le CLI extrait répond à --version avec le même 3.0.68 que le vrai binaire. J’ai essayé 19 commandes en lecture seule comme --version, --help et --help sur chaque sous-commande, et chacune a donné une sortie identique octet pour octet et le même code de sortie que l’original. C’est une bien meilleure vérification que de constater que la sortie ressemble à du JavaScript.
À essayer
git clone https://github.com/vibheksoni/unbuned.git
cd unbuned
python unbuned.py app.exe            # the merged JavaScript
python unbuned.py app.exe --inspect  # what is inside, without writing anything
python unbuned.py app.exe --all      # modules, original sources, assets and bytecode
--all sur Droid écrit plus de 6 000 fichiers en environ quatre secondes et demie.
Si vous voulez le voir fonctionner sur quelque chose que vous connaissez, construisez une petite application avec bun build --compile --sourcemap et lancez unbuned dessus. Vous devriez récupérer vos propres fichiers avec leurs vrais noms.
Utilisez-le sur des binaires que vous avez le droit d’examiner. Il est conçu pour le reverse engineering, la recherche en sécurité, l’analyse de malware et pour récupérer son propre code quand le projet a disparu mais que l’exe est toujours là.
Le code est sur GitHub. Si quelque chose casse sur un binaire Bun que vous avez sous la main, ouvrez une issue, parce que la plupart des correctifs de cet outil sont venus d’un vrai binaire qui l’a fait planter.