Bun-Executables auseinandernehmen mit unbuned
Aus dem Englischen übersetzt. Original lesen auf English.
Warum ich das gebaut habe
Ich reverse gerne Zeug und schaue mir an, wie Apps unter der Haube wirklich funktionieren. Viele der Tools, die ich benutze, werden inzwischen als kompilierte Bun-Apps ausgeliefert. Coding Agents, CLIs und Desktop-Apps kommen heute alle als eine große Exe und man kann nicht einfach einen Ordner öffnen und das JavaScript lesen wie bei einer normalen Node-App.
Also habe ich unbuned gebaut. Du gibst ihm die Exe und bekommst den Code zurück, aufgeteilt in die echten Dateien mit ihren echten Namen. Wurde die App mit Source Maps gebaut, bekommst du sogar das originale TypeScript zurück. Es ist eine einzige Python-Datei ohne Abhängigkeiten.
Dieser Post zeigt, was wirklich in einer Bun-Executable steckt und wie unbuned sie auseinandernimmt. Jede Zahl hier stammt von einem echten Binary und einem einzigen Befehl, sodass du alles selbst nachprüfen kannst.
Was eine Bun-Executable ist
Wenn du bun build --compile ausführst, nimmt Bun seine eigene Runtime und klebt deine gebündelte App daran. Die Runtime ist bei jeder App dieselbe. Dein Code liegt in einer eigenen Section des Binarys:
| Plattform | Wo die App liegt |
|---|---|
| Windows PE | eine Section namens .bun |
| Linux ELF | eine Section namens .bun |
| macOS Mach-O | das Segment und die Section __BUN,__bun, in Thin- oder Universal-Binaries |
Diese Section ist das ganze Ziel. Alles andere in der Datei ist Bun selbst und dafür nicht interessant. Die erste Aufgabe ist, die Section zu finden.
Schritt 1: Die Section finden
Unter Windows heißt das, die PE-Section-Tabelle zu durchlaufen. Die Tabelle beginnt direkt nach dem Optional Header und jeder Eintrag ist 40 Bytes lang, mit dem Namen in den ersten 8:
num_sections = struct.unpack('<H', data[pe_offset+6:pe_offset+8])[0]
optional_header_size = struct.unpack('<H', data[pe_offset+20:pe_offset+22])[0]
section_table_offset = pe_offset + 24 + optional_header_size

for i in range(num_sections):
    section_offset = section_table_offset + (i * 40)
    section_name = data[section_offset:section_offset+8].rstrip(b'\x00').decode('ascii', errors='ignore')
    if section_name == '.bun':
        ...
ELF und Mach-O werden genauso behandelt, mit ihren jeweiligen Headern. Bei einem Universal-Mach-O wählt unbuned zuerst den passenden Architektur-Slice. Wenn nichts davon klappt, sucht es als Fallback nach Buns Magic Bytes, sodass auch ein Binary mit kaputten Section-Metadaten noch gelesen werden kann.
Die Datei wird per Memory Mapping eingebunden statt in den RAM geladen. Manche dieser Binaries sind fast 300 MB groß und es gibt keinen Grund, das alles zu lesen.
Schritt 2: Bun hinterlässt am Ende eine Karte
Das ist der Teil, der echte Dateinamen möglich gemacht hat. Bun hängt nicht einfach nur deinen Code aneinander. Bevor es die Section schreibt, baut es eine Tabelle aller eingebetteten Dateien, den sogenannten StandaloneModuleGraph, und legt diese Tabelle ganz ans Ende.
Die letzten 16 Bytes der Section sind ein literaler Marker:
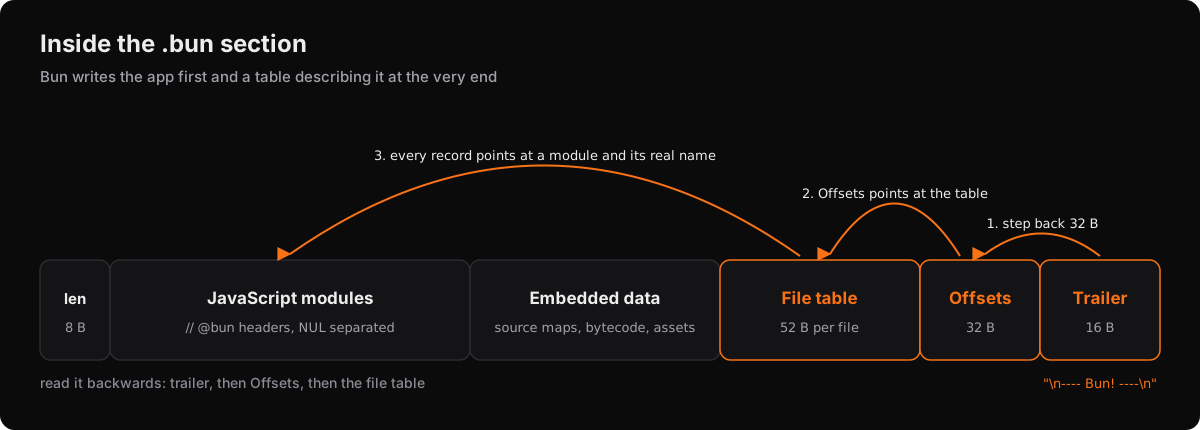
\n---- Bun! ----\nDie 32 Bytes direkt vor diesem Marker sind eine Offsets-Struktur. Sie enthält die Größe der Daten, einen Pointer auf die Dateitabelle, die ID des Entry Points und eine Reihe von Flags:
...file records...
Offsets   { byte_count, modules_ptr, entry_point_id, compile_exec_argv_ptr, flags }
TRAILER   "\n---- Bun! ----\n"
Du suchst also von hinten nach dem Trailer, gehst 32 Bytes zurück und weißt jetzt, wo die Dateitabelle liegt. Jede Datei bekommt einen Record mit 52 Bytes:
name                  { u32 offset, u32 length }
contents              { u32 offset, u32 length }
sourcemap             { u32 offset, u32 length }
bytecode              { u32 offset, u32 length }
module_info           { u32 offset, u32 length }
bytecode_origin_path  { u32 offset, u32 length }
encoding              u8     0 binary, 1 latin1, 2 utf16
loader                u8     0 js, 1 jsx, 2 ts, 3 tsx, 4 json, 5 file, ...
module_format         u8     0 none, 1 esm, 2 cjs
side                  u8     0 server, 1 client
Ein Detail ist wichtiger, als es aussieht. Jeder dieser Offsets ist relativ zum Anfang der Section plus dem eigenen 8 Byte langen Längen-Header der Section. Wenn du dieses +8 vergisst, landet jeder Pointer 8 Bytes zu früh und die ganze Tabelle liest sich wie Müll. Der Parser prüft das ebenfalls. Wenn byte_count + 8 nicht genau auf den Header trifft, lehnt er die Tabelle ab, statt sie halb zu lesen.
Die Records werden in Ladereihenfolge geschrieben, mit dem Entry Point zuerst. Das heißt, der contents-Offset eines Moduls ist genau die Stelle, an der sein Text im Bundle beginnt, und ein Modul zu benennen wird zu einem Lookup statt zu einer Raterei. Factorys Droid CLI ist ein 275 MB großes Binary und unbuned darauf ausgeführt liefert:
modules named from module graph: 623 of 623
Module graph: 706 embedded files
Entry point: B:/~BUN/root/droid
Graph loaders: 623 jsx, 43 binary, 40 file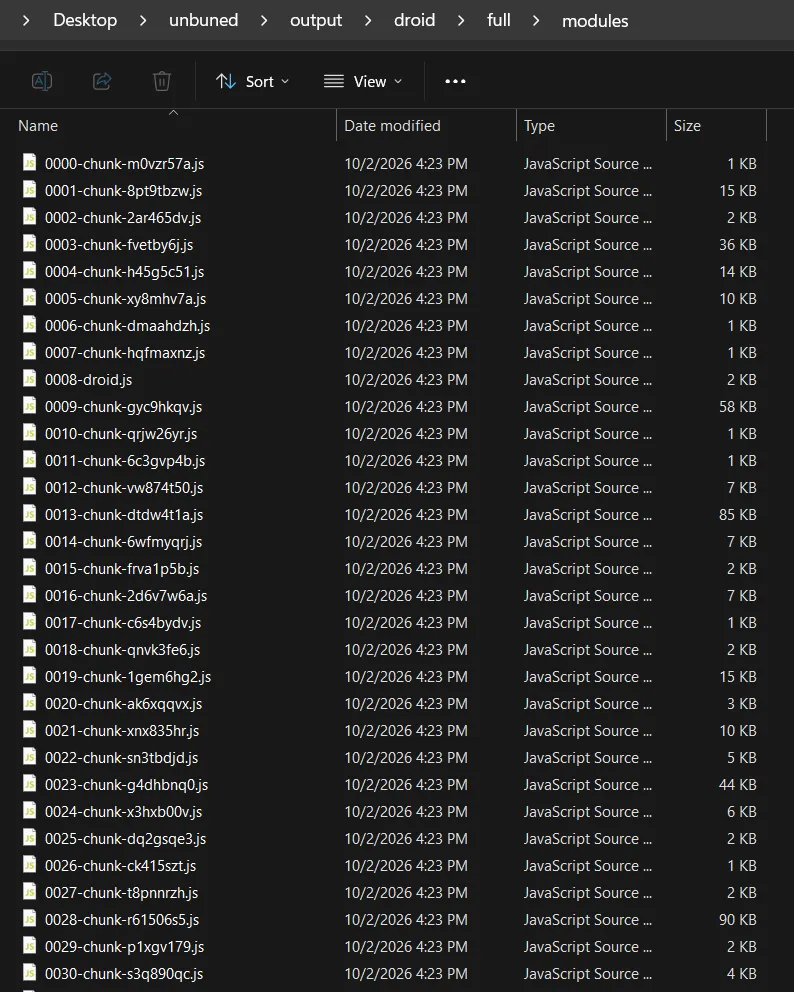
Der Graph kann dir keine Namen geben, die Bun schon weggeworfen hat. Wenn Bun die Tabelle schreibt, sind die Chunks bereits zu Namen wie chunk-9fxe9jf7.js gehasht, also bekommst du genau das. unbuned gibt wieder, was der Compiler aufgezeichnet hat, und tut nicht so, als wüsste es mehr.
Schritt 3: Wo das JavaScript endet
Das Bundle selbst ist eine Liste kompilierter Module. Jedes beginnt mit einer // @bun-Headerzeile und die Module sind durch ein NUL-Byte getrennt. Den Anfang zu finden ist leicht. Das Ende zu finden war der schwierige Teil.
Direkt nach dem letzten Modul kommen Buns Metadaten und die sind nicht sauber binär. Bun mischt druckbare Bytes hinein, sodass der Bereich nach dem Code bei etwa 60 % Nicht-Text liegt, während normaler Quellcode unter 10 % bleibt. Manche Module enthalten außerdem echte NUL-Bytes, man kann also nicht einfach beim ersten aufhören.
Was funktioniert hat: vorwärts ab dem letzten Modul-Header scannen, von dem bekannt ist, dass er Text ist, und dort stoppen, wo die Dichte an Nicht-Text-Bytes sprunghaft ansteigt. Es macht einen groben Durchlauf, dann einen feinen, und landet so auf dem exakten Byte statt am Rand eines Scan-Fensters. Außerdem sucht es nach den Markern, die Bun am Ende des Codes hinterlässt, wie //# sourceMappingURL= und //# debugId=.
Die Byte-Prüfung läuft über bytes.translate, sodass eine 150 MB große Section in CPythons C-Code gescannt wird statt in einer Python-Schleife.
Das exakt hinzubekommen war wichtig. Eine frühere Version stoppte an einem Fensterrand und hat beim Amp CLI das letzte export default b3n(); in der Mitte durchgeschnitten. Jetzt endet dieses Bundle da, wo der Quellcode endet, und es lässt sich mit node --check parsen.
Die UTF-16-Überraschung
Das Amp CLI hat mir außerdem beigebracht, dass nicht jedes Bun-Bundle aus einfachen Bytes besteht. Seine gesamte JavaScript-Region ist UTF-16, sodass auf jedes ASCII-Zeichen ein Padding-NUL folgt. Eine Byte-Suche nach // @bun findet nichts und jedes Text-Verhältnis liest sich wie zur Hälfte binär.
Deshalb sucht unbuned den Marker jetzt zuerst als einfache Bytes und dann als UTF-16 in beiden Byte-Reihenfolgen und trägt die gefundene Kodierung durch alle weiteren Schritte mit. Die Offsets bleiben bei den originalen Byte-Positionen, sodass das Manifest die Datei weiterhin so beschreibt, wie sie auf der Platte liegt. Der Text wird erst beim Herausschreiben nach UTF-8 umgewandelt.
Schritt 4: Das originale TypeScript zurückholen
Wenn die App mit Source Maps gebaut wurde, behält Bun den Originaltext jeder Datei in dem Source-Map-Record, auf den jedes Modul zeigt. Das ist der einzige Ort, an dem das originale TypeScript überlebt, weil das Bundle selbst schon zu Chunks flachgedrückt ist.
Es ist nicht die JSON-Source-Map, die man erwarten würde. Bun liest dieses JSON beim Kompilieren einmal und schreibt stattdessen eine kompakte Tabelle:
| Offset | Inhalt |
|---|---|
0 | u32 Anzahl der Sources |
4 | u32 Länge des rohen VLQ-Mappings |
8 | ein {offset, length}-Pointer pro Source-Pfad |
| danach | ein {offset, length}-Pointer pro Source-Text |
| danach | der VLQ-Mapping-Blob |
| danach | jeder Pfad, dann jeder Source-Text, komprimiert mit Zstandard |
Die Pfade sind relativ zu der Datei, die sie importiert hat, sodass eine geteilte Abhängigkeit als ../../node_modules/... auftaucht. Wenn man die führenden ..-Teile entfernt, landet jede Datei wieder dort, wo sie wirklich lag:
src/index.ts
src/exec/acpDaemonRunner.ts
packages/logging/src/tracing/enums.ts
node_modules/@opentelemetry/api/build/src/version.js
Bei Droid sind das 4.914 Originaldateien und 42,6 MB Quellcode: 2.487 Dependency-Dateien, 1.281 Dateien aus dem eigenen src der App und 1.146 Dateien aus den Workspace-Packages.
Freebuff zeigt, warum das wichtig ist. Es liefert ein einziges minifiziertes Modul mit 7,4 MB aus Namen wie zUA und xH, ohne etwas zum Aufteilen. Seine Source Map enthielt trotzdem das echte Projekt und unbuned hat 1.241 Originaldateien und 13,5 MB TypeScript und JavaScript herausgezogen, angeordnet in den echten Ordnern src/, common/, packages/ und sdk/.
Der andere Kram da drin
Bytecode
Wenn eine App mit --bytecode gebaut wird, ist das JavaScript, das du extrahierst, nur der Fallback. Was tatsächlich läuft, ist JavaScriptCore-Bytecode. unbuned sagt dir, wenn das der Fall ist, und kann pro Modul einen Bytecode-Blob schreiben, anhand der Pointer im Modulgraph. Jeder Blob beginnt mit demselben Header und die Länge in diesem Header stimmte bei jedem Modul, das ich getestet habe, mit der Länge im Graph überein, was eine schöne Kontrolle dafür ist, dass die Extraktion stimmt.
Bytecode wird nicht zurück in JavaScript verwandelt. JSC-Bytecode ist undokumentiert und ändert sich zwischen Releases, das wäre also ein ganzes Compiler-Backend und kein Feature für ein Wochenende.
Eingebettete Dateien
Eine Bun-App besteht nicht nur aus JavaScript. Andere Dateien liegen in derselben Section und viele davon sind als Zstandard-Frames komprimiert. Droid liefert 80 davon mit, zusammen etwa 88 MB, darunter rg.exe, keytar, die rust_pty-Bibliotheken für vier Plattformen und die SKILL.md-Dateien, die sein Agent liest. Der Modulgraph benennt alle 80, also kommen sie mit ihren echten Namen zurück. Zstandard ist die einzige optionale Komponente. Ohne sie werden die Dateien trotzdem herausgezogen, nur eben komprimiert belassen.
Lesbar machen
Bun liefert minifizierten Code aus und minifizierter Code ist pro Modul eine riesige Zeile. Prettier und die anderen Formatter sind Node-Packages, die einen vollständigen Syntaxbaum bauen, und das passt nicht zu einem Python-Tool in einer einzigen Datei und wird bei einem 40 MB großen Bundle langsam.
Also hat unbuned seinen eigenen Formatter. Er ist ein Single-Pass-Lexer, der nur nach den Dingen sucht, die das Layout ändern, wie Strings, Template Literals, Kommentare, Regex-Literale, Operatoren und Klammern, und alles dazwischen unverändert kopiert.
Er hat eine harte Regel. Er fügt nur Whitespace hinzu oder entfernt ihn. Kein Token wird umgeschrieben und nichts wird umsortiert, sodass immer Folgendes gilt:
assert "".join(extracted.split()) == "".join(formatted.split())Beim Testen des Formatters ist mir auch eine Falle in Node aufgefallen. node --check module.js parst eine Datei nur dann wirklich, wenn kein import oder export darin vorkommt. Ein Bun-Bundle hat die immer, also besteht die Prüfung per Dateipfad, ohne irgendetwas zu parsen. Man muss die Datei per Pipe hineinreichen:
node --check --input-type=module < module.jsBeweis, dass es funktioniert
Der echte Test war Clines CLI in Version 3.0.68. Es hat 212 einzelne Module und hat den Extractor mehr zerlegt als jedes andere Ziel. Ein Modul versteckte sich hinter einem Shebang, den kein Header-Muster sehen konnte, und der Formatter hat stillschweigend Leerzeichen in URLs innerhalb einer eingebetteten tree-sitter-Query-Datei eingefügt. Beides wurde wegen dieses einen Binarys behoben.
Nach diesen Fixes stimmen die wieder zusammengesetzten Module Byte für Byte mit dem originalen Bundle überein:
modules: 212
js length: 18386663
rebuilt length: 18386663
identical: True
Danach habe ich den Modulbaum mit den 13 Assets daneben zurück auf die Platte geschrieben und ausgeführt. Das extrahierte CLI antwortet auf --version mit demselben 3.0.68 wie das echte Binary. Ich habe 19 schreibgeschützte Befehle ausprobiert, etwa --version, --help und --help bei jedem Subcommand, und jeder lieferte byte-identische Ausgabe und denselben Exit-Code wie das Original. Das ist eine viel bessere Kontrolle, als dass die Ausgabe nur wie JavaScript aussieht.
Probier es aus
git clone https://github.com/vibheksoni/unbuned.git
cd unbuned
python unbuned.py app.exe            # the merged JavaScript
python unbuned.py app.exe --inspect  # what is inside, without writing anything
python unbuned.py app.exe --all      # modules, original sources, assets and bytecode
--all schreibt bei Droid über 6.000 Dateien in etwa viereinhalb Sekunden.
Wenn du sehen willst, wie es an etwas funktioniert, das du kennst, bau einfach eine kleine App mit bun build --compile --sourcemap und lass unbuned darauf laufen. Du solltest deine eigenen Dateien mit ihren echten Namen zurückbekommen.
Benutze es an Binaries, die du dir ansehen darfst. Es ist gebaut für Reverse Engineering, Security-Forschung, Malware-Analyse und dafür, den eigenen Code zurückzuholen, wenn das Projekt weg ist, aber die Exe noch existiert.
Der Code liegt auf GitHub. Wenn etwas an einem Bun-Binary kaputtgeht, das du hast, öffne ein Issue, denn die meisten Fixes in diesem Tool kamen daher, dass ein echtes Binary es zerlegt hat.