Comment j’ai construit stealth-browser-mcp
Traduit de l’anglais. Lire l’original en English.
Pourquoi je l’ai construit
En août 2025 mes agents d’IA se faisaient bloquer à chaque fois qu’ils essayaient de naviguer avec Playwright. Une page se chargeait normalement dans mon Chrome et la même page rendait à l’agent une coquille vide. Je voulais que mes agents naviguent davantage comme moi, alors j’ai construit ma propre solution et je l’ai publiée sur GitHub sous le nom stealth-browser-mcp.
L’idée était simple. Au lieu d’un navigateur de test qui s’annonce tout seul, je voulais que mon agent pilote un vrai Chrome et voie ce que je vois dans DevTools pendant qu’il le fait.
Je pensais que quelques personnes auraient le même problème. Il a aujourd’hui près de 3 000 étoiles et 390 forks et 9 personnes que je n’ai jamais rencontrées ont eu des pull requests fusionnées dedans. Cet article explique comment il fonctionne et ce que j’ai appris en le construisant.
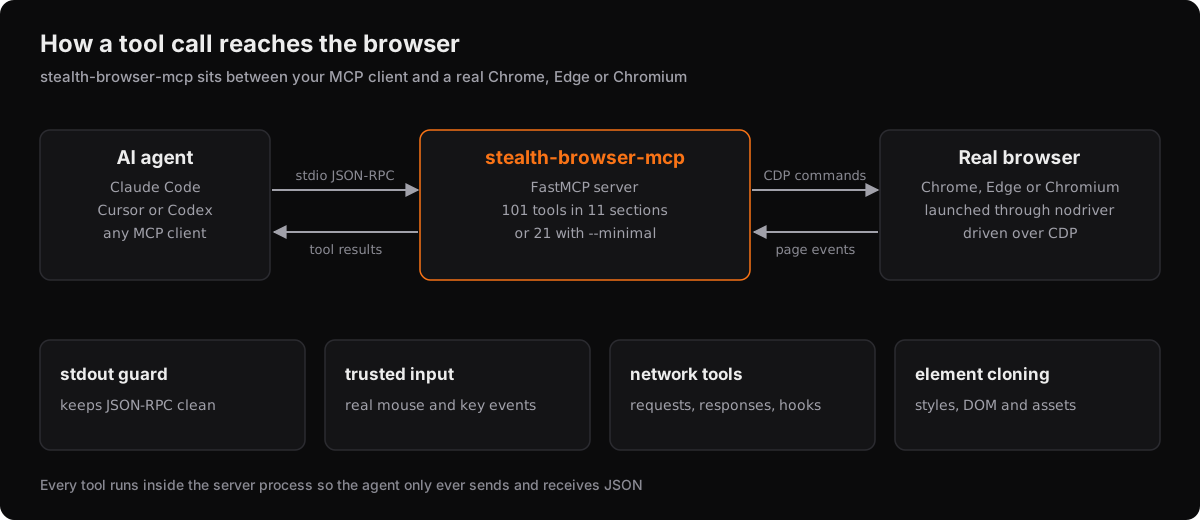
Comment ça s’assemble
stealth-browser-mcp est un serveur MCP écrit en Python au-dessus de FastMCP. Votre agent lui parle depuis n’importe quel client MCP comme Claude Code, Cursor ou Codex. Le serveur pilote un vrai Chrome, Edge ou Chromium via nodriver et le Chrome DevTools Protocol.
Cette séparation est tout le design. nodriver lance un navigateur normal comme un utilisateur le lancerait et me donne une connexion CDP dessus. Tout le reste dont j’ai besoin vit dans cette connexion, donc le serveur est surtout un ensemble d’outils soignés par-dessus.
MCP est ce qui le rend utilisable par un agent. Chaque chose que le navigateur sait faire est un outil avec un nom que le modèle peut choisir et le modèle reçoit un résultat texte normal. L’agent n’a jamais besoin d’écrire du code Playwright ni de gérer le cycle de vie d’un navigateur parce que le serveur s’occupe de tout ça.
La partie que personne ne voit
Au début du projet les outils fonctionnaient puis le client coupait la connexion d’un coup sans erreur que je puisse voir.
Le bug était print(). En transport stdio le descripteur de fichier 1 est le canal JSON-RPC. N’importe quel print() de mon code ou d’une dépendance atterrit au milieu d’une trame JSON-RPC et le client coupe la connexion pour se protéger. nodriver imprime aussi, donc nettoyer mes propres fichiers ne suffisait pas.
La correction est un petit garde dans stdio_guard.py que j’installe juste avant de démarrer le transport. Il remplace sys.stdout par un proxy qui envoie les écritures Python vers stderr. Le transport continue de fonctionner parce qu’il a enveloppé le vrai tampon stdout avant l’échange et ne regarde plus jamais sys.stdout.
Ce seul fichier explique pourquoi les logs de debug marchent normalement. Vous mettez STEALTH_BROWSER_DEBUG=1 et vous obtenez des logs détaillés sur stderr avec le protocole intact.
Entrée fiable
Beaucoup d’automatisations cliquent en appelant element.click() depuis JavaScript. Ça marche jusqu’au moment où la page vérifie si le clic vient d’une vraie main. Je voulais que les événements d’entrée ressemblent à de l’entrée.
input_actions.py envoie de vrais événements d’entrée CDP. Un clic résout le nœud, le fait défiler dans la vue et attend que la position arrête de bouger puis envoie mousePressed et mouseReleased avec de vraies coordonnées. La souris parcourt un chemin court avec adoucissement et un peu de bruit au lieu de se téléporter sur la cible et la dernière position est mémorisée par onglet pour que le mouvement suivant parte d’où le curseur se trouve vraiment.
La saisie fonctionne pareil. Chaque caractère est mappé sur les champs clavier qu’une disposition US produirait et sort comme un vrai événement de touche. Vider un champ sélectionne le contenu et le supprime comme le ferait une personne au lieu de mettre value à vide et de déclencher un faux événement.
Ce détail compte plus qu’il n’y paraît. Le benchmark hebdomadaire a une vérification appelée fidélité d’entrée et elle échoue si le clic et la saisie ne produisent pas des événements fiables dans un ordre réel sans rien injecté dans la page.
Ce que les outils font
Le serveur embarque 101 outils en 11 sections et vous pouvez faire tourner une surface plus petite quand vous n’avez pas besoin de tout.
| Mode | Outils | Quand |
|---|---|---|
| Complet | 101 | Tout ce qui suit |
--minimal | 21 | Naviguer, cliquer, lire des pages |
--disable-* | votre choix | Retirer une section comme les hooks |
--xpool-safe | 84 | Retirer les outils qui déclenchent Runtime.enable |
--list-sections affiche les sections et leur taille pour que vous construisiez votre propre sous-ensemble. La raison des sections c’est le contexte. Chaque outil exposé coûte des tokens dans le prompt de l’agent et un modèle avec 101 options choisit la mauvaise plus souvent qu’un modèle avec 21.
Inspection réseau
Un agent peut lister les requêtes d’une page et lire les en-têtes, le payload et le corps capturé. C’est l’outil que j’utilise le plus quand je regarde comment fonctionne l’API d’un site parce que l’agent peut suivre une requête de la page jusqu’à la réponse et répondre à des questions dessus sans que j’ouvre DevTools.
Hooks dynamiques
Les hooks sont de petites fonctions Python que l’agent écrit à l’exécution et qui regardent chaque requête pour la bloquer, la rediriger, remplacer la réponse ou la laisser passer. Un agent qui repère un appel analytics très bavard écrit un hook qui le supprime et lit la page sans le bruit.
Les limites sont volontaires. Le code du hook tourne avec une liste blanche de builtins avec len, str, any et all donc rien dans un hook ne peut lire un fichier ni faire sa propre requête réseau. Un validateur analyse chaque fonction et rejette eval, exec, open et input avant que quoi que ce soit tourne.
Clonage d’éléments
Avec un sélecteur CSS le serveur extrait l’élément avec ses styles calculés, sa structure DOM, ses ressources et ses animations. C’est assez pour reconstruire une section ailleurs avec les vraies polices et les vrais espacements plutôt qu’une approximation.
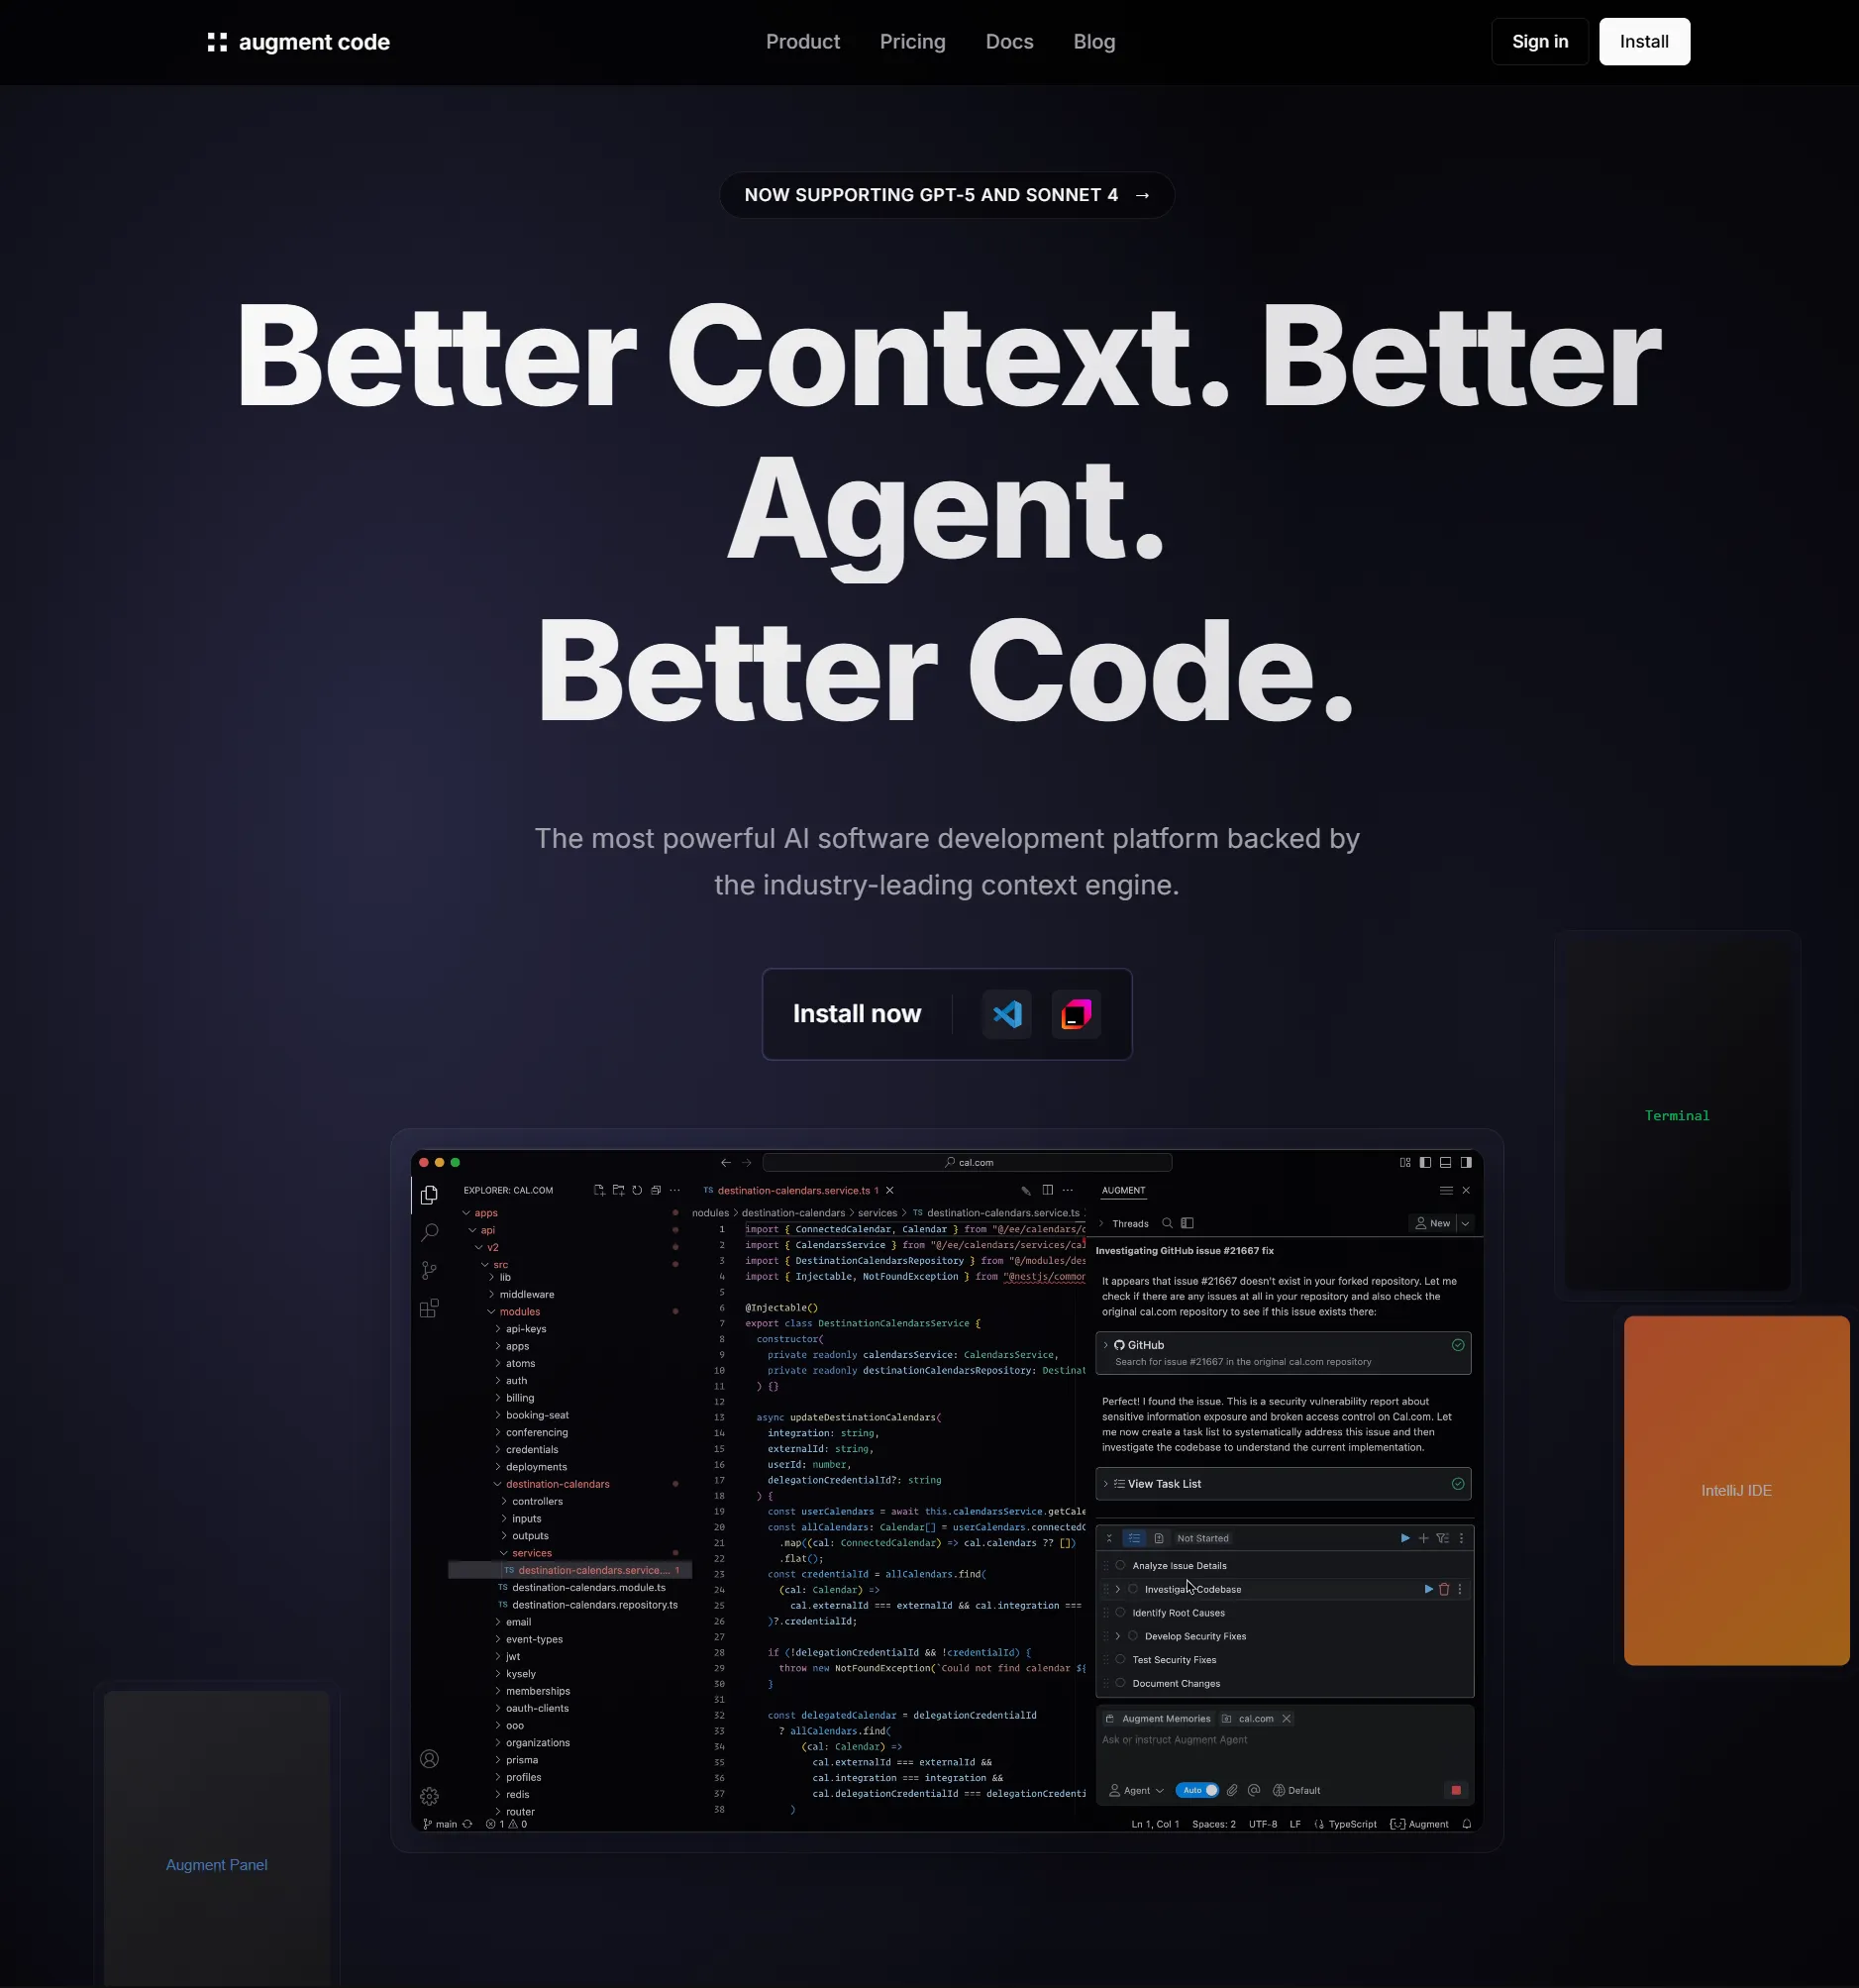
Le clone du hero d’Augment Code est la meilleure démo. Tout a été un seul message à Claude pour lancer un navigateur, aller sur le site et cloner le hero. Il a extrait l’élément et est revenu avec une recréation fonctionnelle et responsive en deux minutes environ.
Bindings de page
Les bindings de page sont le connecteur qui va dans l’autre sens. La page reçoit window.<nom>(...) et chaque appel renvoie une promesse qui part dans la file pour l’agent. L’agent lit les appels avec get_page_binding_calls et répond avec resolve_page_binding_call.
Rien de la page ni de l’agent ne tourne sur l’hôte du serveur. Les arguments doivent être du JSON et la longueur de file comme la taille du payload sont plafonnées pour qu’une page ne puisse pas épuiser la mémoire en appelant un binding en boucle.
Où je me trompais sur le stealth
Mon premier README faisait passer le stealth pour un problème résolu. Il ne l’est pas et j’ai changé ma façon d’en parler.
Le dépôt lance un benchmark chaque semaine dans GitHub Actions sur Linux, macOS et Windows, en headless et avec fenêtre, avec le Chrome actuel et le précédent. Il vérifie les flags de lancement, une sonde locale d’empreinte, l’injection de script, la fidélité d’entrée, Sannysoft, Intoli, CreepJS, un défi JS Cloudflare et l’empreinte TLS et HTTP/2. Chaque exécution écrit du JSON dans docs/stealth-results/ et le tableau du README est généré à partir de ces fichiers au lieu d’être tapé à la main.
La dernière exécution est honnête d’une façon plus utile qu’une promesse. macOS et Windows passent tout. Les runners Linux passent 7, se dégradent sur 1 et échouent sur 1 parce que les runners Linux de GitHub n’ont pas de GPU donc Chrome rend WebGL avec un moteur logiciel et Sannysoft le signale. Sur une machine avec un vrai GPU ça n’apparaît pas.
Quand une cible qui passait se dégrade le workflow ouvre tout seul un ticket stealth-regression. C’est la partie qui compte le plus pour moi. La détection change chaque mois donc un chiffre dans un README est une mesure à une date. Il ne dit rien d’aujourd’hui.
Le modèle de confiance
Ce serveur est puissant d’une façon qu’on oublie facilement. Il peut exécuter du JavaScript dans une page, lire les cookies et le stockage, intercepter et réécrire le trafic réseau, exécuter des commandes CDP et envoyer des fichiers depuis des dossiers autorisés.
Donc le modèle de confiance est écrit. L’agent ou le client MCP est le principal de sécurité. La configuration recommandée est stdio local avec un client auquel vous faites confiance. Si vous utilisez le transport HTTP vous définissez STEALTH_BROWSER_MCP_AUTH_TOKEN et vous ne l’exposez pas à l’internet ouvert.
Les envois de fichiers ne lisent que dans les dossiers de BROWSER_FILE_UPLOAD_ALLOWED_DIRS. Il n’y a pas de chemin autour de cette vérification parce que l’outil résout le chemin réel et le compare aux racines autorisées avant de toucher au fichier.
Ce que j’ai appris
Le bug qui m’a le plus appris est celui de stdout. Un outil qui marche 90 pour cent du temps est pire qu’un outil qui échoue bruyamment parce que vous passez les 10 pour cent restants à douter de votre propre code. Une fois le garde en place chaque échec était un vrai échec.
La deuxième leçon portait sur l’honnêteté dans un README. Dire qu’un navigateur passe tous les détecteurs aurait rapporté plus d’étoiles une semaine et m’aurait coûté toute raison de faire confiance au projet. Un benchmark qui peut échouer en public est le seul qui vaille la peine d’être publié.
La troisième est que les gens utilisent ce que vous construisez si le problème est réel. Mon problème c’était des agents bloqués et 390 forks plus tard il s’avère que beaucoup de gens avaient le même.
Le dépôt est sur github.com/vibheksoni/stealth-browser-mcp. Utilisez-le sur des sites que vous avez le droit d’automatiser et vérifiez les conditions du site vers lequel vous le pointez.