Cómo construí stealth-browser-mcp
Traducido del inglés. Lee el original en English.
Por qué lo construí
En agosto de 2025 mis agentes de IA se quedaban bloqueados cada vez que intentaban navegar con Playwright. Una página cargaba bien en mi Chrome y la misma página le devolvía al agente una cáscara vacía. Quería que mis agentes navegaran más como yo así que construí mi propia solución y la puse en GitHub como stealth-browser-mcp.
La idea era simple. En vez de un navegador de pruebas que se anuncia solo quería que mi agente manejara un Chrome real y viera lo que veo en DevTools mientras lo hace.
Pensé que a unas cuantas personas les pasaría lo mismo. Ahora tiene cerca de 3.000 estrellas y 390 forks y 9 personas que nunca he conocido han tenido pull requests aceptados en él. Este post es cómo funciona y qué aprendí construyéndolo.
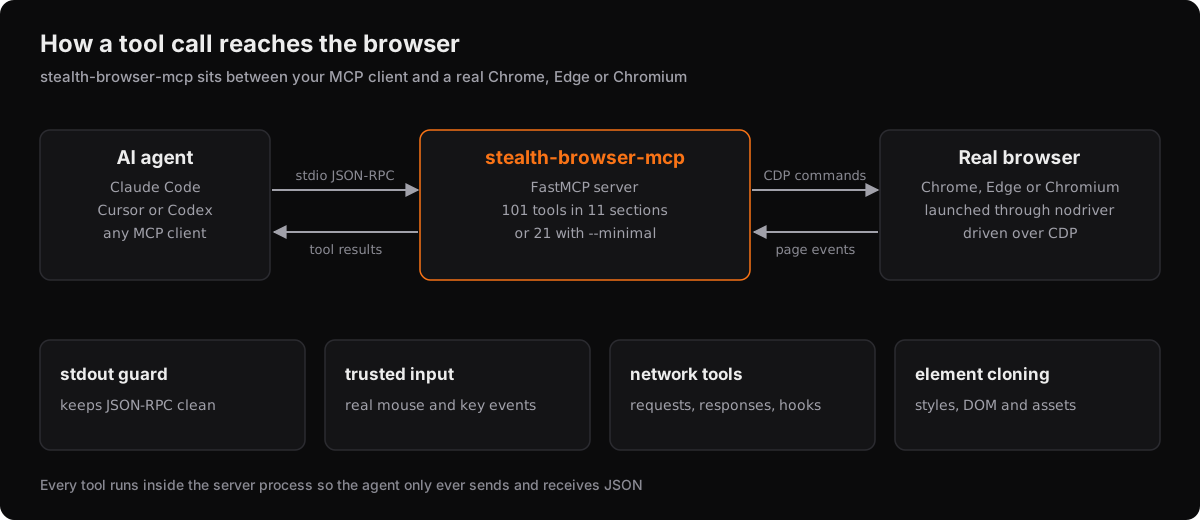
Cómo encaja todo
stealth-browser-mcp es un servidor MCP escrito en Python sobre FastMCP. Tu agente habla con él desde cualquier cliente MCP como Claude Code, Cursor o Codex. El servidor maneja un Chrome, Edge o Chromium real a través de nodriver y el Chrome DevTools Protocol.
Esa división es todo el diseño. nodriver lanza un navegador normal como lo arrancaría un usuario y me da una conexión CDP a él. Todo lo demás que necesito vive en esa conexión así que el servidor es sobre todo un conjunto de herramientas cuidadosas encima de ella.
MCP es lo que lo hace usable por un agente. Cada cosa que el navegador puede hacer es una herramienta con un nombre que el modelo puede elegir y el modelo recibe un resultado de texto normal. El agente nunca necesita escribir código de Playwright ni manejar el ciclo de vida de un navegador porque el servidor es dueño de todo eso.
La parte que nadie ve
Durante mi primer tiempo en este proyecto las herramientas funcionaban y de repente el cliente cortaba la conexión sin ningún error que pudiera ver.
El bug era print(). En transporte stdio el descriptor de archivo 1 es el canal JSON-RPC. Cualquier print() de mi código o de una dependencia cae en medio de una trama JSON-RPC y el cliente corta la conexión para protegerse. nodriver también imprime así que no bastaba con limpiar mis propios archivos.
El arreglo es una pequeña protección en stdio_guard.py que instalo justo antes de arrancar el transporte. Reemplaza sys.stdout con un proxy que manda las escrituras de Python a stderr. El transporte sigue funcionando porque envolvió el buffer real de stdout antes del cambio y nunca vuelve a mirar sys.stdout.
Ese archivo es la razón por la que los logs de depuración siguen funcionando normal. Pones STEALTH_BROWSER_DEBUG=1 y obtienes logs detallados en stderr con el protocolo intacto.
Entrada confiable
Mucha automatización hace clic llamando a element.click() desde JavaScript. Eso funciona hasta que la página revisa si el clic vino de una mano real. Yo quería que los eventos de entrada parecieran entrada.
input_actions.py manda eventos de entrada CDP de verdad. Un clic resuelve el nodo, lo desplaza a la vista y espera a que la posición deje de moverse y después despacha mousePressed y mouseReleased con coordenadas reales. El ratón se mueve por un camino corto con easing y algo de ruido en vez de teletransportarse al objetivo y la última posición se guarda por pestaña para que el siguiente movimiento empiece donde está de verdad el cursor.
Escribir funciona igual. Cada carácter se mapea a los campos de teclado que produciría una distribución US y sale como un evento de tecla real. Limpiar un campo selecciona el contenido y lo borra como lo haría una persona en vez de poner value en cadena vacía y lanzar un evento falso.
Ese detalle importa más de lo que suena. El benchmark semanal tiene un chequeo llamado fidelidad de entrada y falla si el clic y la escritura no producen eventos confiables en un orden real sin nada inyectado en la página.
Qué hacen las herramientas
El servidor trae 101 herramientas en 11 secciones y puedes correr una superficie más chica cuando no necesitas todas.
| Modo | Herramientas | Cuándo usarlo |
|---|---|---|
| Completo | 101 | Todo lo de abajo |
--minimal | 21 | Navegar, hacer clic y leer páginas |
--disable-* | lo que elijas | Quitar una sección como los hooks |
--xpool-safe | 84 | Sacar las herramientas que disparan Runtime.enable |
--list-sections imprime las secciones y sus tamaños para que armes tu propio subconjunto. La razón de las secciones es el contexto. Cada herramienta que expones cuesta tokens en el prompt del agente y un modelo con 101 opciones elige la equivocada más seguido que uno con 21.
Inspección de red
Un agente puede listar las peticiones que hizo una página y leer las cabeceras, el payload y el cuerpo capturado. Es la herramienta que más uso cuando estoy mirando cómo funciona la API de un sitio porque el agente puede seguir una petición desde la página hasta la respuesta y responder preguntas sobre ella sin que yo abra DevTools.
Hooks dinámicos
Los hooks son funciones pequeñas de Python que el agente escribe en tiempo de ejecución y que miran cada petición para bloquearla, redirigirla, reemplazar la respuesta o dejarla pasar. Un agente que detecta una llamada de analítica muy habladora puede escribir un hook que la elimine y leer la página sin el ruido.
Hay límites a propósito. El código del hook corre con una lista blanca de builtins con len, str, any y all así que nada en un hook puede leer un archivo ni hacer su propia llamada de red. Un validador analiza cada función y rechaza eval, exec, open e input antes de que corra nada.
Clonación de elementos
Dado un selector CSS el servidor saca el elemento con sus estilos calculados, su estructura DOM, sus recursos y sus animaciones. Eso basta para reconstruir una sección en otro sitio con las tipografías y el espaciado reales en vez de una aproximación.
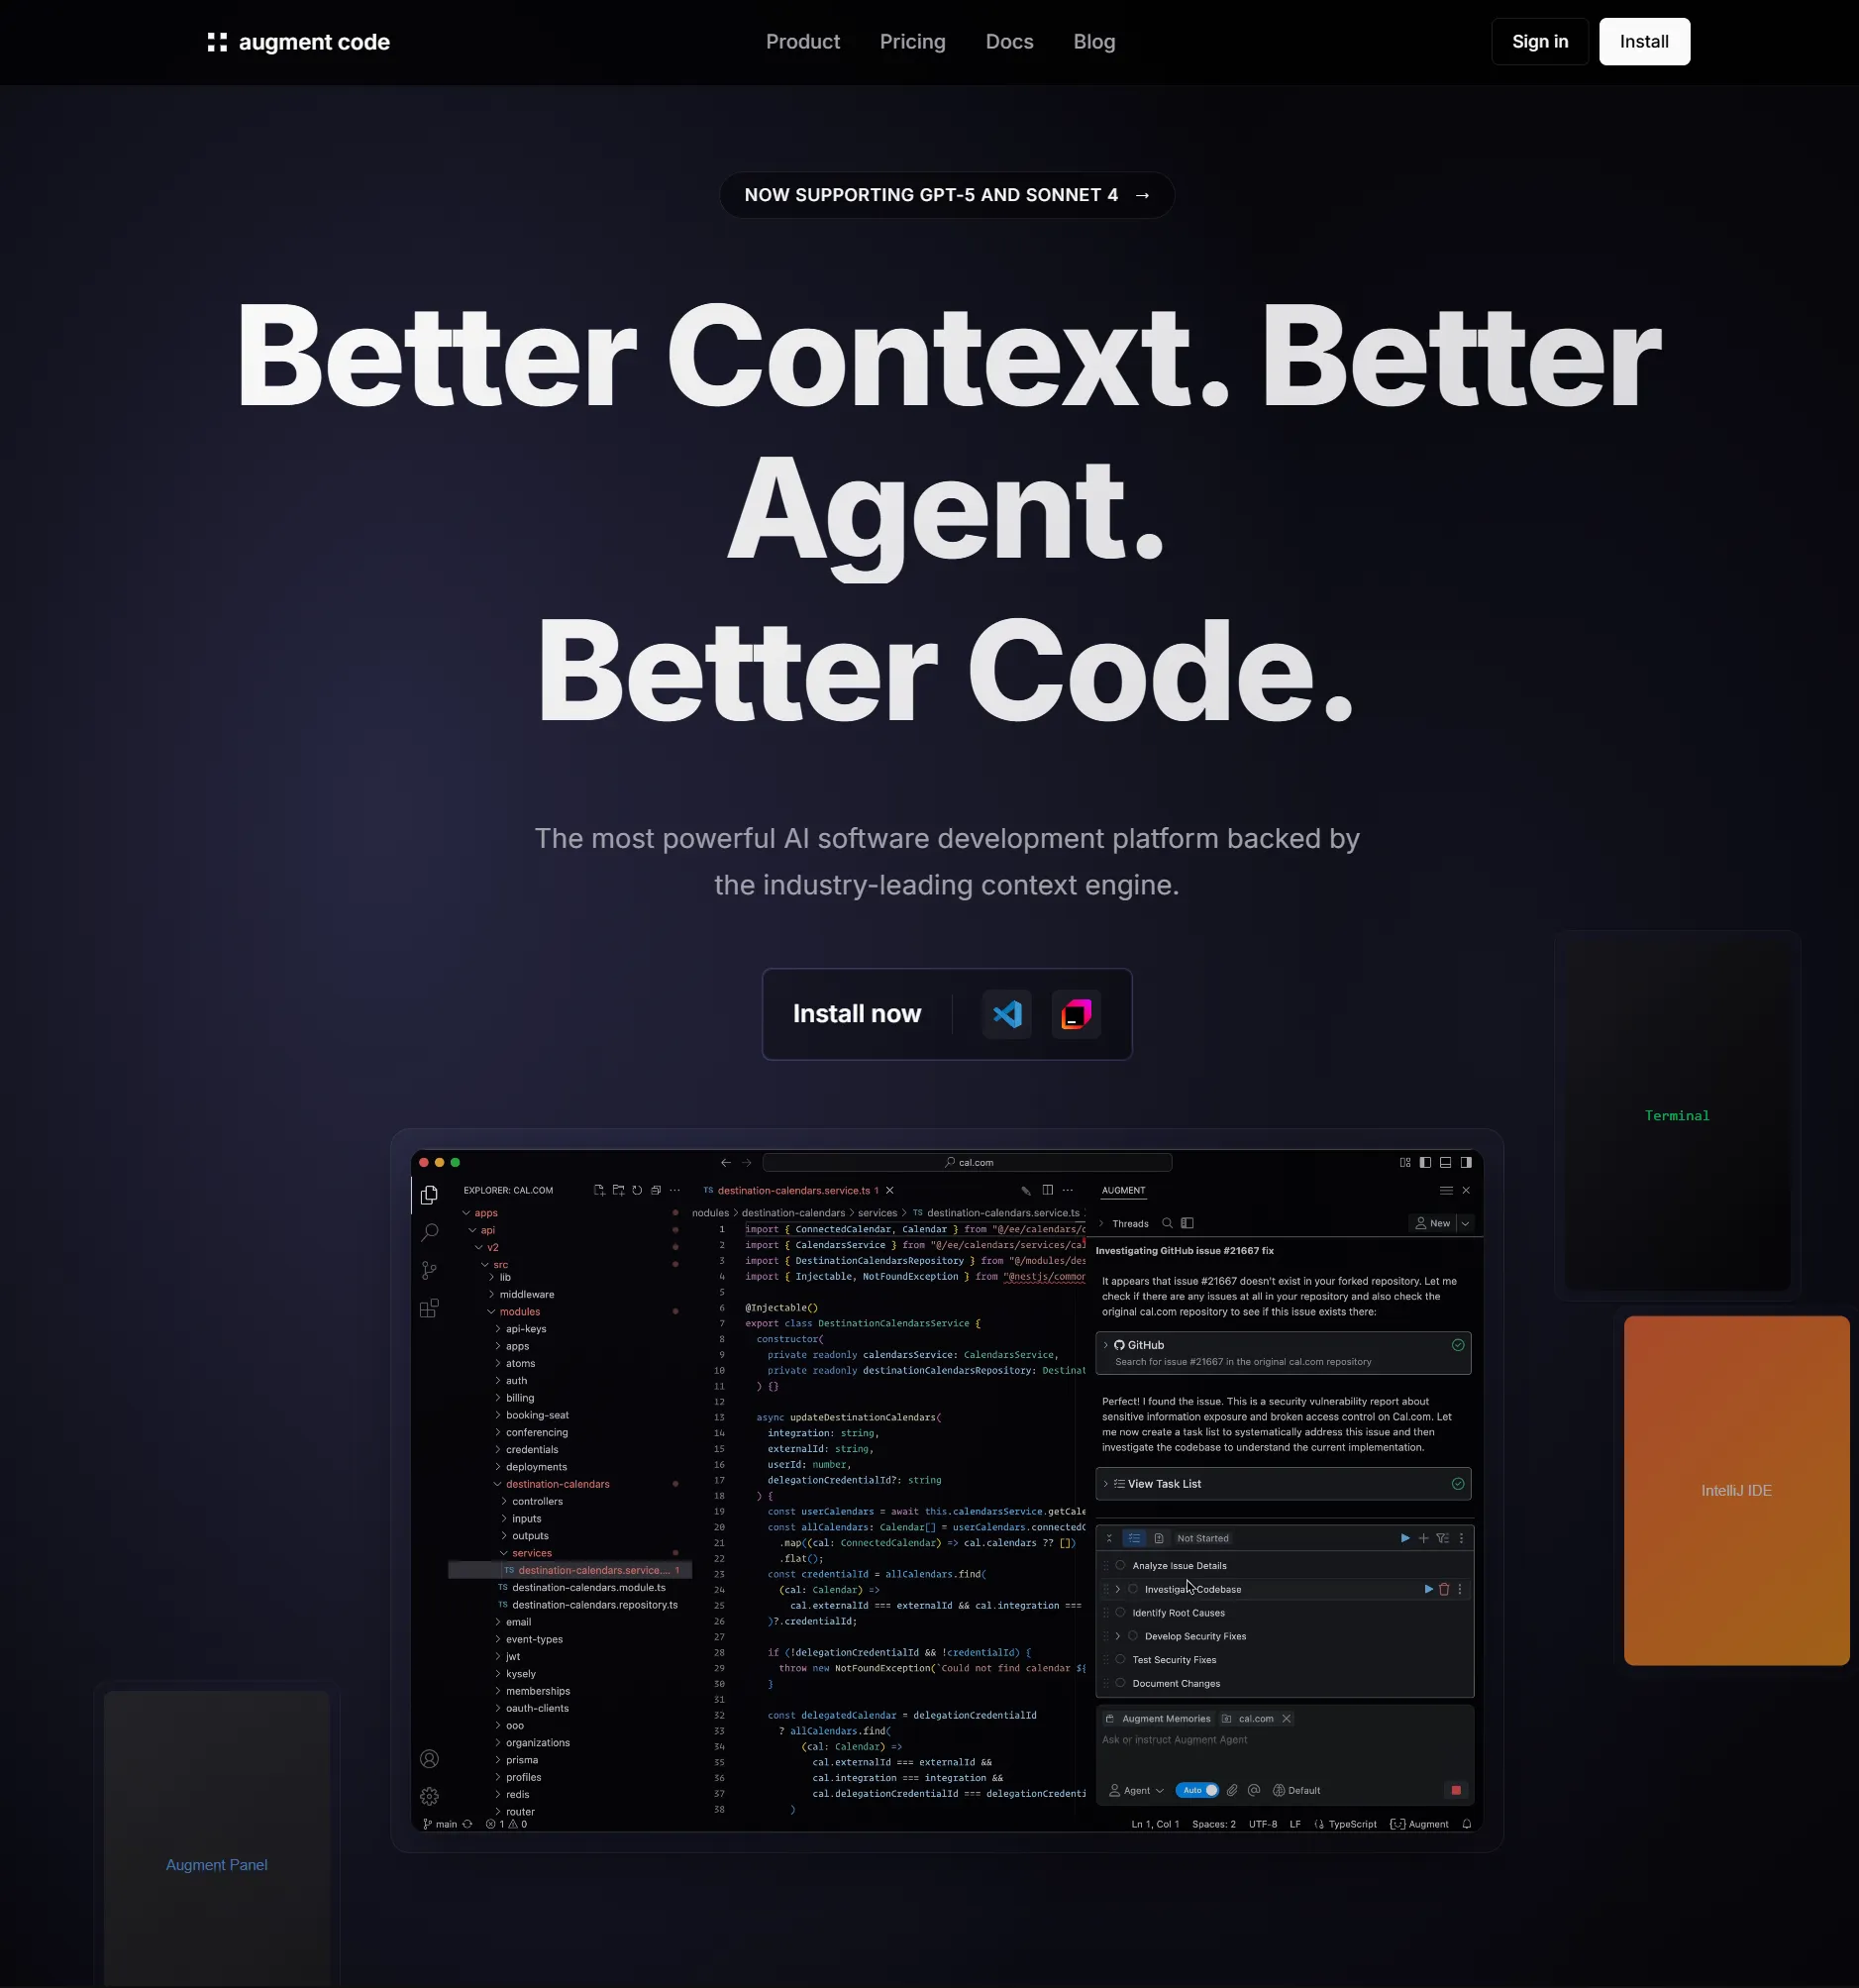
El clon del hero de Augment Code es la mejor demostración. Todo fue un mensaje a Claude para que lanzara un navegador, fuera al sitio y clonara el hero. Extrajo el elemento y volvió con una recreación funcional con comportamiento responsive en unos dos minutos.
Bindings de página
Los bindings de página son el conector que va al otro lado. La página recibe window.<nombre>(...) y cada llamada devuelve una promesa que se encola para el agente. El agente lee las llamadas con get_page_binding_calls y las responde con resolve_page_binding_call.
Nada de la página ni del agente corre en el host del servidor. Los argumentos tienen que ser JSON y tanto el largo de la cola como el tamaño del payload están limitados para que una página no pueda agotar la memoria llamando a un binding en un bucle.
En qué me equivoqué con el stealth
Mi primer README hacía que el stealth sonara como un problema resuelto. No lo es y cambié cómo hablo de esto.
El repo corre un benchmark cada semana en GitHub Actions en Linux, macOS y Windows tanto en headless como en modo con ventana con el Chrome actual y el anterior. Revisa flags de lanzamiento, una sonda local de huella, inyección de scripts, fidelidad de entrada, Sannysoft, Intoli, CreepJS, un desafío JS de Cloudflare y la huella TLS y HTTP/2. Cada corrida escribe JSON en docs/stealth-results/ y la tabla del README se genera desde esos archivos en vez de escribirse a mano.
La corrida más reciente es honesta de una forma más útil que una promesa. macOS y Windows pasan todos los chequeos. Los runners de Linux pasan 7, degradan en 1 y fallan 1 porque los runners de Linux de GitHub no tienen GPU así que Chrome renderiza WebGL con un renderizador por software y Sannysoft lo marca. En una máquina con GPU real eso no aparece.
Cuando un objetivo que solía pasar empeora el workflow abre un issue stealth-regression por su cuenta. Esa es la parte que más me importa. La detección cambia cada mes así que un número en un README es una medición de una fecha. No dice nada sobre hoy.
El modelo de confianza
Este servidor es potente de una forma que se olvida fácil. Puede ejecutar JavaScript en una página, leer cookies y almacenamiento, interceptar y reescribir tráfico de red, ejecutar comandos CDP y subir archivos de carpetas permitidas.
Así que el modelo de confianza está escrito. El agente o el cliente MCP es el principal de seguridad. La configuración recomendada es stdio local con un cliente en el que confías. Si corres el transporte HTTP pones STEALTH_BROWSER_MCP_AUTH_TOKEN y no lo expones al internet abierto.
Las subidas de archivos solo leen de las carpetas en BROWSER_FILE_UPLOAD_ALLOWED_DIRS. No hay forma de rodear ese chequeo porque la herramienta resuelve la ruta real y la compara contra las raíces permitidas antes de tocar el archivo.
Qué aprendí
El bug que más me enseñó fue el de stdout. Una herramienta que funciona el 90 por ciento del tiempo es peor que una que falla de forma ruidosa porque gastas el 10 por ciento restante dudando de tu propio código. Cuando entró la protección cada fallo fue un fallo real.
La segunda lección fue sobre la honestidad en un README. Decir que un navegador pasa todos los detectores habría dado más estrellas durante una semana y me habría costado toda razón para que alguien confiara en el proyecto. Un benchmark que puede fallar en público es el único que vale la pena publicar.
La tercera es que la gente va a usar lo que construyes si el problema es real. Mi problema era que los agentes se bloqueaban y 390 forks después resulta que mucha gente tenía el mismo.
El repo está en github.com/vibheksoni/stealth-browser-mcp. Úsalo en sitios que tienes permitido automatizar y revisa los términos del sitio al que lo apuntas.