Wie ich stealth-browser-mcp gebaut habe
Aus dem Englischen übersetzt. Original lesen auf English.
Warum ich es gebaut habe
Im August 2025 wurden meine KI-Agenten jedes Mal blockiert wenn sie mit Playwright durchs Web gehen wollten. Eine Seite lud in meinem Chrome normal und dieselbe Seite gab dem Agenten eine leere Hülle. Ich wollte dass meine Agenten eher so browsen wie ich, also habe ich meine eigene Lösung gebaut und sie auf GitHub als stealth-browser-mcp veröffentlicht.
Die Idee war einfach. Statt eines Testbrowsers der sich selbst verrät sollte mein Agent ein echtes Chrome steuern und dabei sehen was ich in DevTools sehe.
Ich dachte ein paar Leute hätten dasselbe Problem. Heute sind es knapp 3.000 Sterne und 390 Forks und 9 Leute die ich nie getroffen habe, haben Pull Requests darin untergebracht. Dieser Beitrag erklärt wie es funktioniert und was ich beim Bauen gelernt habe.
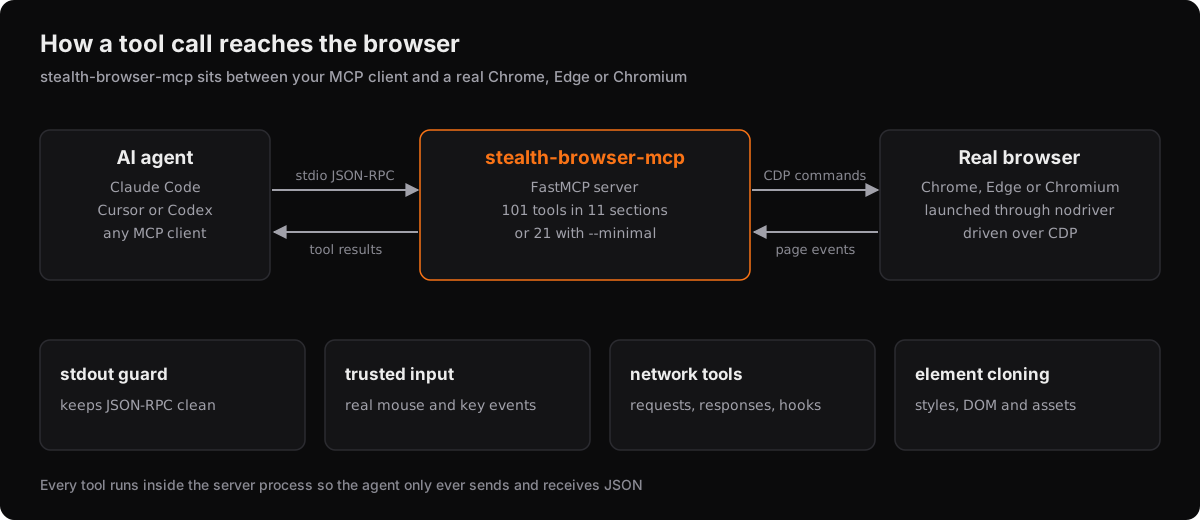
Wie es zusammenspielt
stealth-browser-mcp ist ein MCP-Server in Python auf Basis von FastMCP. Dein Agent spricht über jeden MCP-Client wie Claude Code, Cursor oder Codex mit ihm. Der Server steuert ein echtes Chrome, Edge oder Chromium über nodriver und das Chrome DevTools Protocol.
Diese Trennung ist das ganze Design. nodriver startet einen normalen Browser so wie ein Nutzer ihn starten würde und gibt mir eine CDP-Verbindung dazu. Alles andere das ich brauche lebt in dieser Verbindung, also ist der Server vor allem ein sorgfältiger Satz Werkzeuge darüber.
MCP macht das für einen Agenten benutzbar. Alles was der Browser kann ist ein Werkzeug mit einem Namen den das Modell wählen kann und das Modell bekommt ein normales Textergebnis zurück. Der Agent muss nie Playwright-Code schreiben oder den Lebenszyklus eines Browsers verwalten weil der Server das alles besitzt.
Der Teil den niemand sieht
In der ersten Zeit an diesem Projekt funktionierten die Werkzeuge und dann brach der Client plötzlich die Verbindung ab ohne Fehler den ich sehen konnte.
Der Bug war print(). Beim stdio-Transport ist Dateideskriptor 1 der JSON-RPC-Kanal. Jedes print() aus meinem Code oder aus einer Abhängigkeit landet mitten in einem JSON-RPC-Rahmen und der Client bricht die Verbindung ab um sich zu schützen. nodriver druckt auch, also reichte es nicht meine eigenen Dateien zu säubern.
Die Lösung ist ein kleiner Schutz in stdio_guard.py den ich direkt vor dem Start des Transports installiere. Er ersetzt sys.stdout durch einen Proxy der Python-Schreibvorgänge nach stderr schickt. Der Transport läuft weiter weil er den echten stdout-Puffer vor dem Tausch umhüllt hat und nie wieder auf sys.stdout schaut.
Diese eine Datei ist der Grund warum Debug-Logging weiter normal funktioniert. Du setzt STEALTH_BROWSER_DEBUG=1 und bekommst ausführliche Logs auf stderr bei unberührtem Protokoll.
Vertrauenswürdige Eingabe
Viele Automatisierungen klicken durch einen Aufruf von element.click() aus JavaScript. Das funktioniert bis die Seite prüft ob der Klick von einer echten Hand kam. Ich wollte dass die Eingabeereignisse wie Eingabe aussehen.
input_actions.py schickt echte CDP-Eingabeereignisse. Ein Klick löst den Knoten auf, scrollt ihn ins Bild und wartet bis die Position aufhört sich zu bewegen und schickt dann mousePressed und mouseReleased mit echten Koordinaten. Die Maus wandert auf einem kurzen gedämpften Pfad mit etwas Rauschen statt zum Ziel zu springen und die letzte Position wird pro Tab gemerkt damit die nächste Bewegung dort beginnt wo der Cursor wirklich ist.
Tippen funktioniert genauso. Jedes Zeichen wird auf die Tastenfelder gemappt die ein US-Layout erzeugen würde und geht als echtes Tastenereignis raus. Ein Feld zu leeren markiert den Inhalt und löscht ihn wie ein Mensch es tun würde statt value auf leer zu setzen und ein gefälschtes Ereignis zu feuern.
Das Detail zählt mehr als es klingt. Der wöchentliche Benchmark hat eine Prüfung namens Eingabetreue und sie schlägt fehl wenn Klick und Tippen keine vertrauenswürdigen Ereignisse in echter Reihenfolge erzeugen und nichts in die Seite injiziert wird.
Was die Werkzeuge tun
Der Server liefert 101 Werkzeuge in 11 Abschnitten und du kannst eine kleinere Fläche fahren wenn du nicht alle brauchst.
| Modus | Werkzeuge | Wann |
|---|---|---|
| Voll | 101 | Alles unten |
--minimal | 21 | Navigieren, klicken, Seiten lesen |
--disable-* | deine Wahl | Einen Abschnitt wie die Hooks entfernen |
--xpool-safe | 84 | Werkzeuge entfernen die Runtime.enable auslösen |
--list-sections zeigt die Abschnitte und ihre Größen damit du deine eigene Teilmenge baust. Der Grund für Abschnitte ist Kontext. Jedes Werkzeug das du anbietest kostet Tokens im Prompt des Agenten und ein Modell mit 101 Optionen greift öfter daneben als eines mit 21.
Netzwerk-Inspektion
Ein Agent kann die Anfragen einer Seite auflisten und Header, Payload und mitgeschnittenen Body lesen. Das ist das Werkzeug das ich am meisten nutze wenn ich schaue wie die API einer Seite funktioniert weil der Agent eine Anfrage von der Seite bis zur Antwort verfolgen und Fragen dazu beantworten kann ohne dass ich DevTools öffne.
Dynamische Hooks
Hooks sind kleine Python-Funktionen die der Agent zur Laufzeit schreibt und die jede Anfrage ansehen um sie zu blockieren, umzuleiten, die Antwort zu ersetzen oder durchzulassen. Ein Agent der einen geschwätzigen Analytics-Aufruf erkennt schreibt einen Hook der ihn entfernt und liest die Seite ohne das Rauschen.
Die Grenzen sind Absicht. Hook-Code läuft mit einer Whitelist aus len, str, any und all, also kann nichts in einem Hook eine Datei lesen oder selbst eine Netzwerkanfrage stellen. Ein Validator parst jede Funktion und lehnt eval, exec, open und input ab bevor irgendetwas läuft.
Element-Klonen
Mit einem CSS-Selektor holt der Server das Element mit berechneten Styles, DOM-Struktur, Assets und Animationen. Das reicht um einen Abschnitt anderswo mit echten Schriften und Abständen nachzubauen statt einer Annäherung.
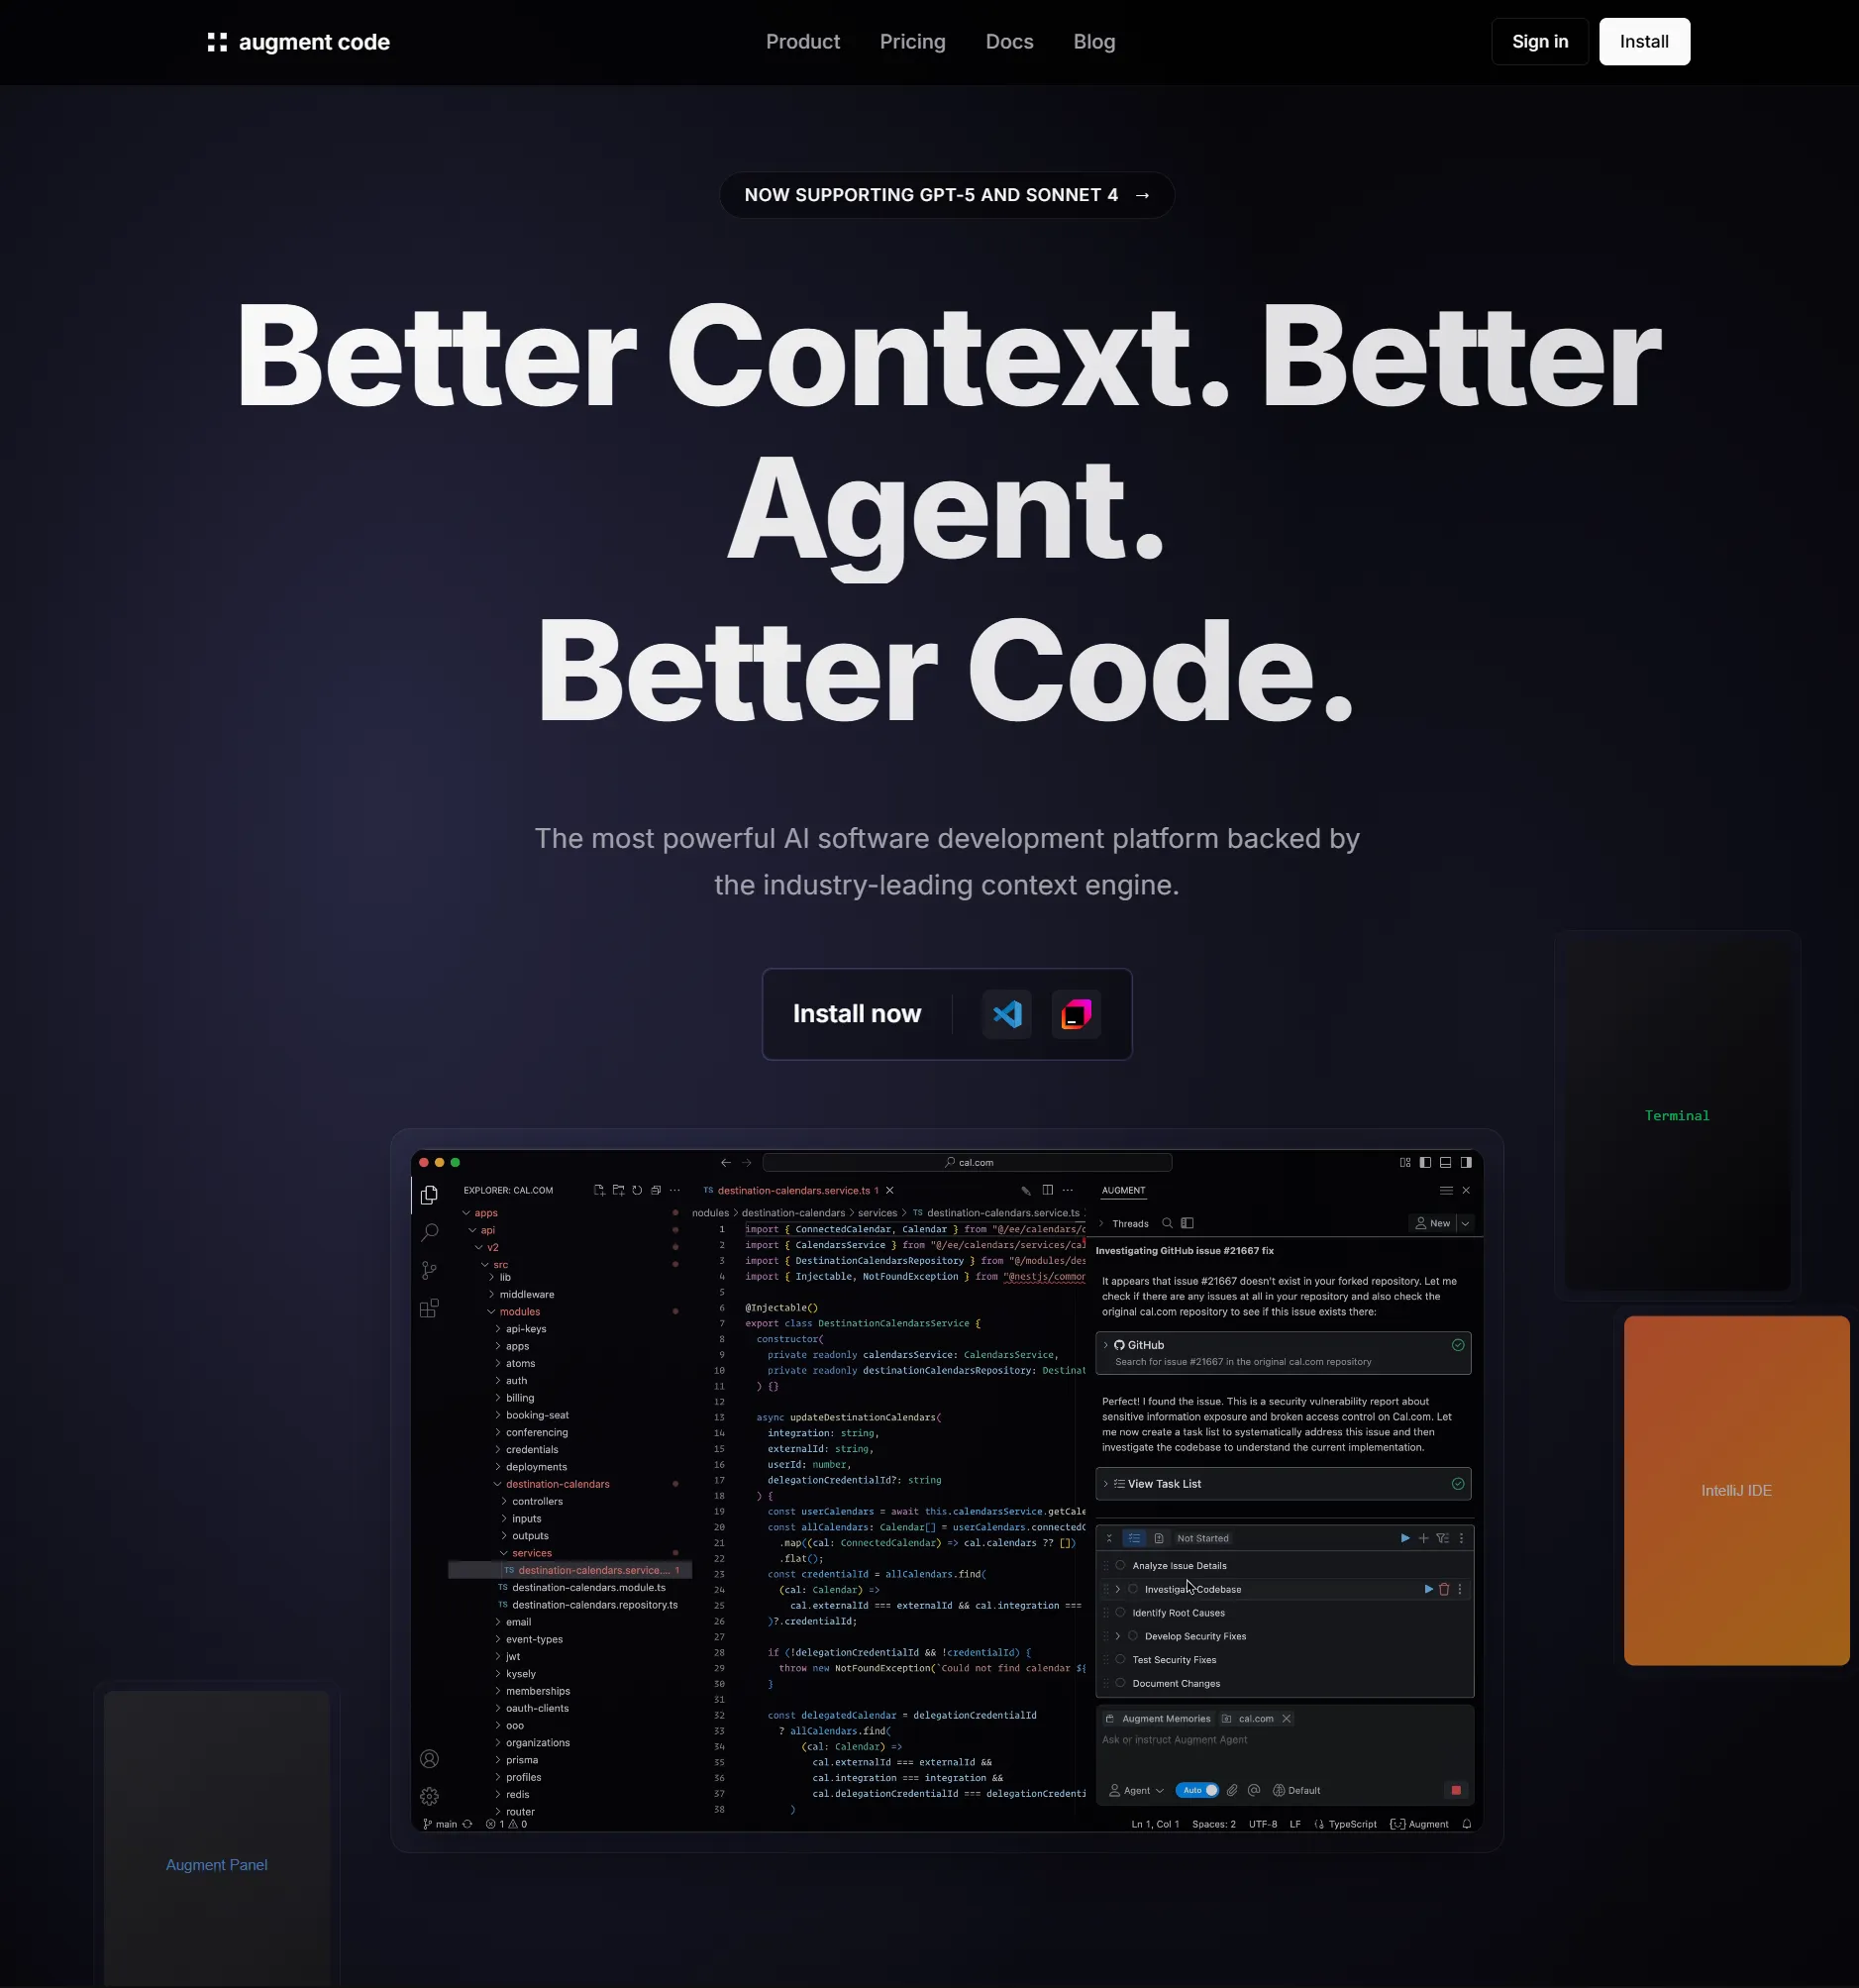
Der Hero-Klon von Augment Code ist die beste Demo. Das Ganze war eine Nachricht an Claude: Browser starten, zur Seite gehen, den Hero klonen. Es hat das Element extrahiert und kam in etwa zwei Minuten mit einem funktionierenden responsiven Nachbau zurück.
Seiten-Bindings
Seiten-Bindings sind der Stecker in die andere Richtung. Die Seite bekommt window.<name>(...) und jeder Aufruf gibt ein Promise zurück das für den Agenten eingereiht wird. Der Agent liest die Aufrufe mit get_page_binding_calls und antwortet mit resolve_page_binding_call.
Nichts von der Seite oder vom Agenten läuft auf dem Server-Host. Argumente müssen JSON sein und sowohl Warteschlangenlänge als auch Payload-Größe sind begrenzt damit eine Seite nicht durch eine Schleife den Speicher erschöpfen kann.
Wo ich beim Stealth falsch lag
Mein erstes README klang als wäre Stealth ein gelöstes Problem. Ist es nicht und ich habe geändert wie ich darüber spreche.
Das Repo fährt jede Woche einen Benchmark in GitHub Actions auf Linux, macOS und Windows, headless und mit Fenster, mit dem aktuellen und dem vorherigen Chrome. Er prüft Startflags, eine lokale Fingerprint-Sonde, Skript-Injektion, Eingabetreue, Sannysoft, Intoli, CreepJS, eine Cloudflare-JS-Challenge und den TLS- und HTTP/2-Fingerprint. Jeder Lauf schreibt JSON nach docs/stealth-results/ und die Tabelle im README wird aus diesen Dateien erzeugt statt von Hand getippt.
Der letzte Lauf ist auf eine Art ehrlich die nützlicher ist als eine Behauptung. macOS und Windows bestehen alles. Die Linux-Runner bestehen 7, verschlechtern sich bei 1 und fallen bei 1 durch weil die Linux-Runner von GitHub keine GPU haben, also rendert Chrome WebGL mit einem Software-Renderer und Sannysoft markiert das. Auf einer Maschine mit echter GPU taucht das nicht auf.
Wenn ein Ziel das vorher bestand schlechter wird öffnet der Workflow von selbst ein stealth-regression-Issue. Das ist der Teil der mir am wichtigsten ist. Erkennung ändert sich jeden Monat, also ist eine Zahl im README eine Messung von einem Datum. Über heute sagt sie nichts.
Das Vertrauensmodell
Dieser Server ist auf eine Art mächtig die man leicht vergisst. Er kann JavaScript in einer Seite ausführen, Cookies und Storage lesen, Netzwerkverkehr abfangen und umschreiben, CDP-Befehle ausführen und Dateien aus erlaubten Ordnern hochladen.
Deshalb steht das Vertrauensmodell geschrieben. Der Agent oder der MCP-Client ist der Sicherheitsprinzipal. Empfohlen ist lokales stdio mit einem Client dem du vertraust. Wenn du den HTTP-Transport nutzt setzt du STEALTH_BROWSER_MCP_AUTH_TOKEN und stellst ihn nicht ins offene Internet.
Datei-Uploads lesen nur aus Ordnern in BROWSER_FILE_UPLOAD_ALLOWED_DIRS. Es gibt keinen Weg um diese Prüfung herum weil das Werkzeug den echten Pfad auflöst und mit den erlaubten Wurzeln vergleicht bevor es die Datei anfasst.
Was ich gelernt habe
Der Bug der mir am meisten beigebracht hat war der mit stdout. Ein Werkzeug das 90 Prozent der Zeit funktioniert ist schlimmer als eines das laut scheitert weil du die fehlenden 10 Prozent damit verbringst deinen eigenen Code anzuzweifeln. Als der Schutz drin war, war jeder Fehlschlag ein echter Fehlschlag.
Die zweite Lektion war Ehrlichkeit im README. Zu sagen ein Browser bestehe jeden Detektor hätte für eine Woche mehr Sterne gebracht und mir jeden Grund genommen dass jemand dem Projekt traut. Ein Benchmark der öffentlich scheitern kann ist der einzige der es wert ist veröffentlicht zu werden.
Die dritte ist dass Leute nutzen was du baust wenn das Problem echt ist. Mein Problem waren blockierte Agenten und 390 Forks später stellte sich heraus dass viele dasselbe hatten.
Das Repo ist auf github.com/vibheksoni/stealth-browser-mcp. Nutze es auf Seiten die du automatisieren darfst und prüfe die Bedingungen der Seite auf die du es richtest.